介绍 Artificial Analysis Intelligence Index v5
介绍 Artificial Analysis Intelligence Index v5:新增 FrontierCode 2.0 与 Terminal-Bench-Science,升级 HLE-Diamond、AA-Omniscience v1.1 和 CritPt v2,60% 权重来自私有或 held-out 数据。Claude Opus 5.5 (max) 以 58 分居首,open weights 差距扩大到 12 分,并分析成本、effort、token 用量及 Progress Index v1。
展开文章目录
非官方中文译文。本文是对 Artificial Analysis 原文《Announcing Artificial Analysis Intelligence Index v5》(2026 年 10 月 27 日发布)的中文翻译,版权归 Artificial Analysis 所有。模型名、benchmark 名等特定名词与术语保留英文原文;完整内容及最新数据请以原文为准。
Index v5 引入 2 个新 benchmark 和 3 项升级。Index 首次有过半权重建立在私有数据集之上
v5 总览
Artificial Analysis Intelligence Index 是我们的综合智能指数,衡量模型在反映当下真实使用场景的任务上的能力。v5 是自 1 月 v4 发布以来规模最大的一次升级。随着 v5 上线,Index 中 60% 的权重来自带有私有测试集或 held-out answers 的评测。
与 Intelligence Index v5 一同发布的,还有 Artificial Analysis Progress Index v1:它在同一条连续刻度上追踪模型能力随时间的变化。
评测构成与权重
新加入 Intelligence Index:
➤ **FrontierCode 2.0:**Cognition 新发布的私有 benchmark,测真实世界的 coding 任务,以"仓库维护者是否会合并 agent 的改动"来评分
➤ **Terminal-Bench-Science:**70 个 agentic 科学研究任务,在终端环境中运行
升级项:
➤ **HLE-Diamond(取代 Humanity's Last Exam):**Humanity's Last Exam 的精校 1,000 题版本,推理题与知识题各占一半
➤ **AA-Omniscience v1.1:**更新后的数据集——移除已饱和题目与公开集题目,新增题目,修订含糊或有误的题目
➤ **CritPt v2:**CritPt v2 的私有 40 题 hard subset,由 CritPt 作者修订,并带 code execution 工具运行
**留在 Index 中:**AA-Briefcase、AutomationBench-AA、GDP.pdf 与 Terminal-Bench 4.0
**从 Index 中移除:**GDPval-AA v2.1、SciCode 与 AA-LCR v1.1
Intelligence Index v5 权重:
➤ **Knowledge Work(25%):**AA-Briefcase(15%)、AutomationBench-AA(5%)与 GDP.pdf(5%)
➤ **Coding(25%):**FrontierCode 2.0(15%)与 Terminal-Bench 4.0(10%)
➤ **Science(25%):**Terminal-Bench-Science(15%)与 CritPt v2 hard subset(10%)
➤ **General(25%):**AA-Omniscience v1.1 占 15%(10% accuracy、5% non-hallucination)与 HLE-Diamond(10%)
总得分情况
关键结果:
➤ **Claude Opus 5.5 (max) 以 58 分居首,领先 GPT-6 Astra(max,57 分)与 GPT-6.1 Sol(max,55 分):**Anthropic 与 OpenAI 包揽前五名。Gemini 4 Argon(high)以 50 分紧随其后
➤ **open weights 差距从 3 分拉大到 12 分:**Kimi K3.1 Pro(weights 尚未发布)是排名最高的 open weights 模型,得 46 分。在已发布 weights 的模型中,DeepSeek V4.1 Flash 1017 (max) 与 GLM-5.3 (max) 以 32 分领先——落后榜首 26 分,且低于 Claude Haiku 5.5(max,36 分)
➤ **领先模型之间每任务成本相差超过 13 倍:**在所示得分最高的 10 个模型中,GPT-6.1 Terra(max)最便宜,每个 Intelligence Index 任务 0.96 美元;Claude Fable 5.1(max)最贵,为 13.04 美元
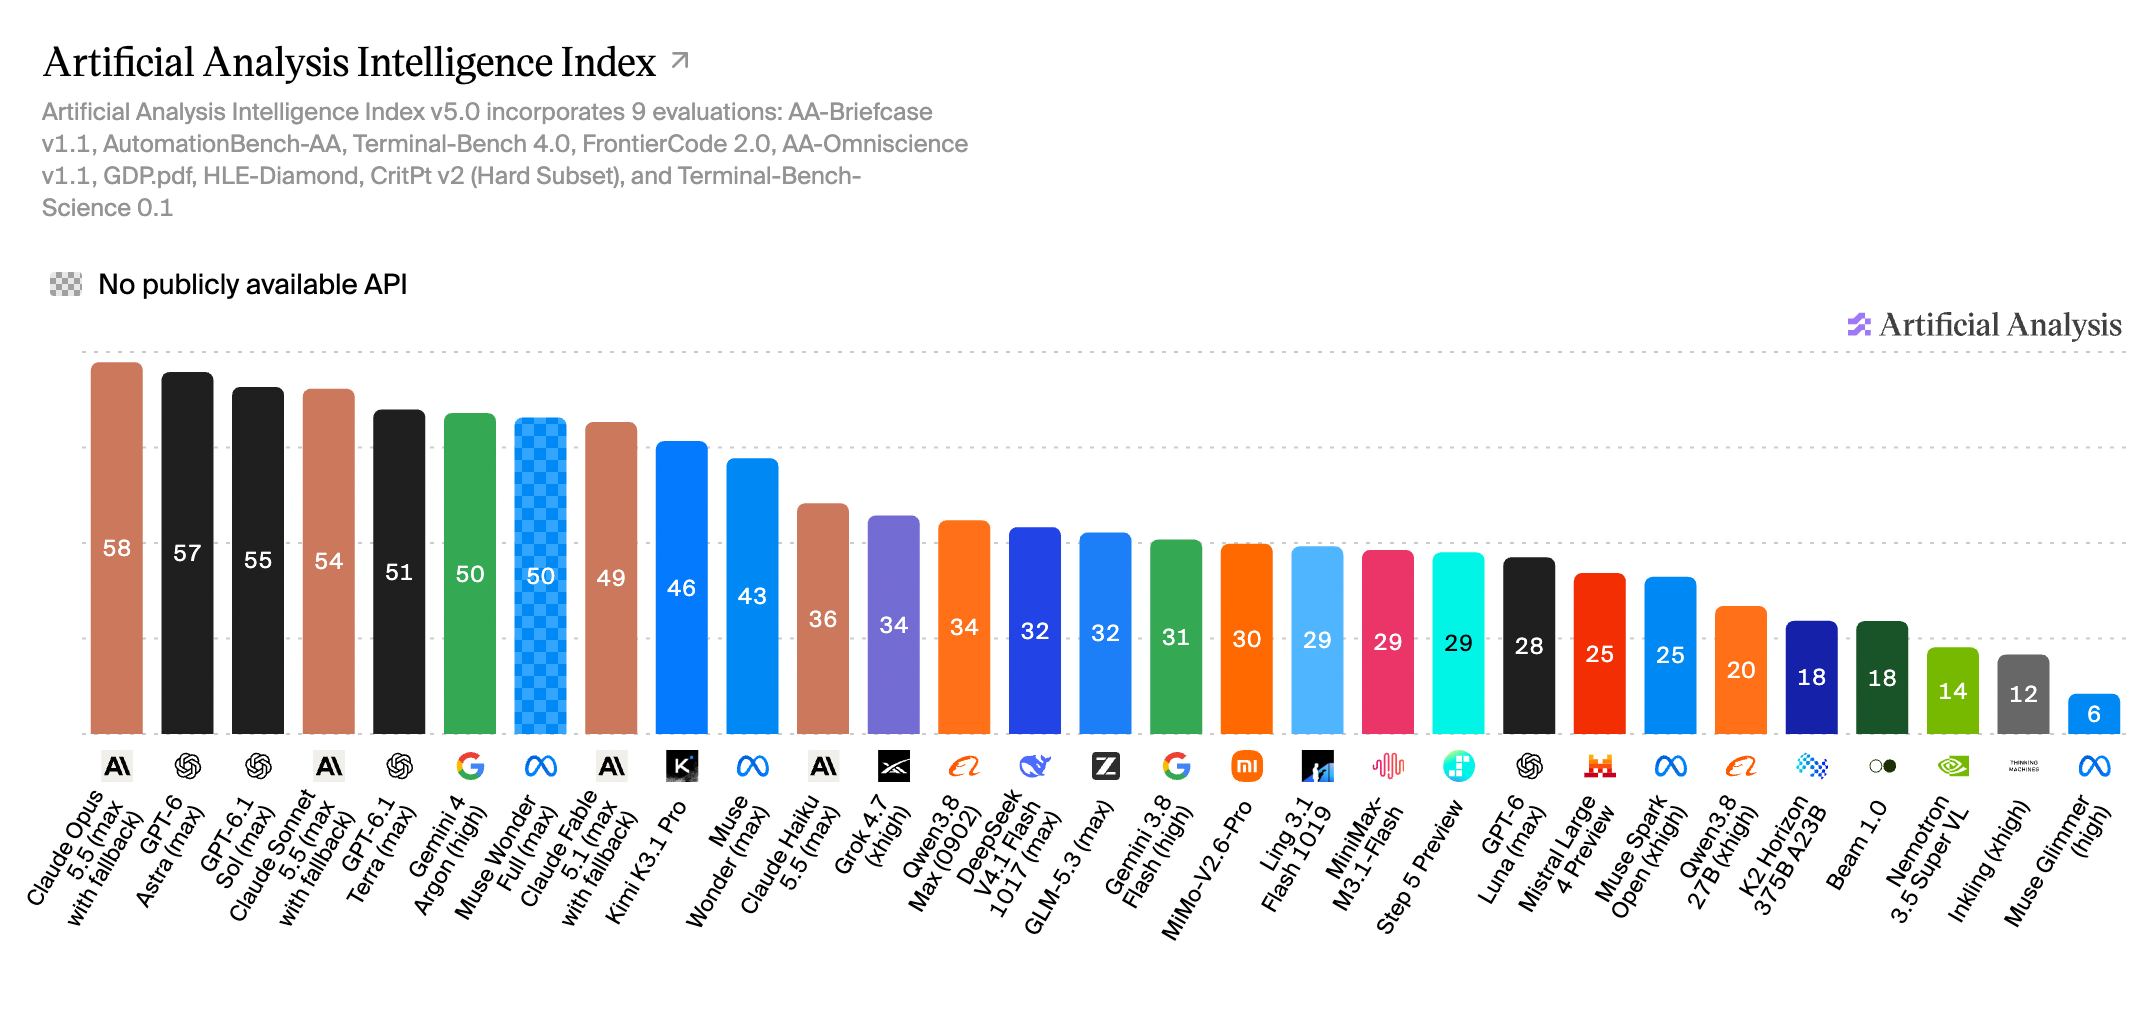
图 1:Intelligence Index v5 总榜,综合 9 项评测的加权结果。
分项得分情况
FrontierCode 2.0
**FrontierCode 2.0 是 Cognition 私有 coding benchmark 的最新版本。**它于今天早些时候发布,包含真实开源仓库中的 132 个任务,以"维护者是否会合并 agent 的改动"评分。任何 blocking check 失败的尝试记 0 分;任务保持私有以避免 contamination。我们在自研 agentic harness Stirrup 中把每个任务跑三遍。
Claude Opus 5.5 (max) 以 46% 领先,GPT-6 Astra (max)、GPT-6.1 Terra (max) 与 Claude Sonnet 5.5 (max) 均为 42%。DeepSeek V4.1 Flash 1017 (max) 是得分最高的 open weights 模型,为 28%,落后榜首 18 个百分点。
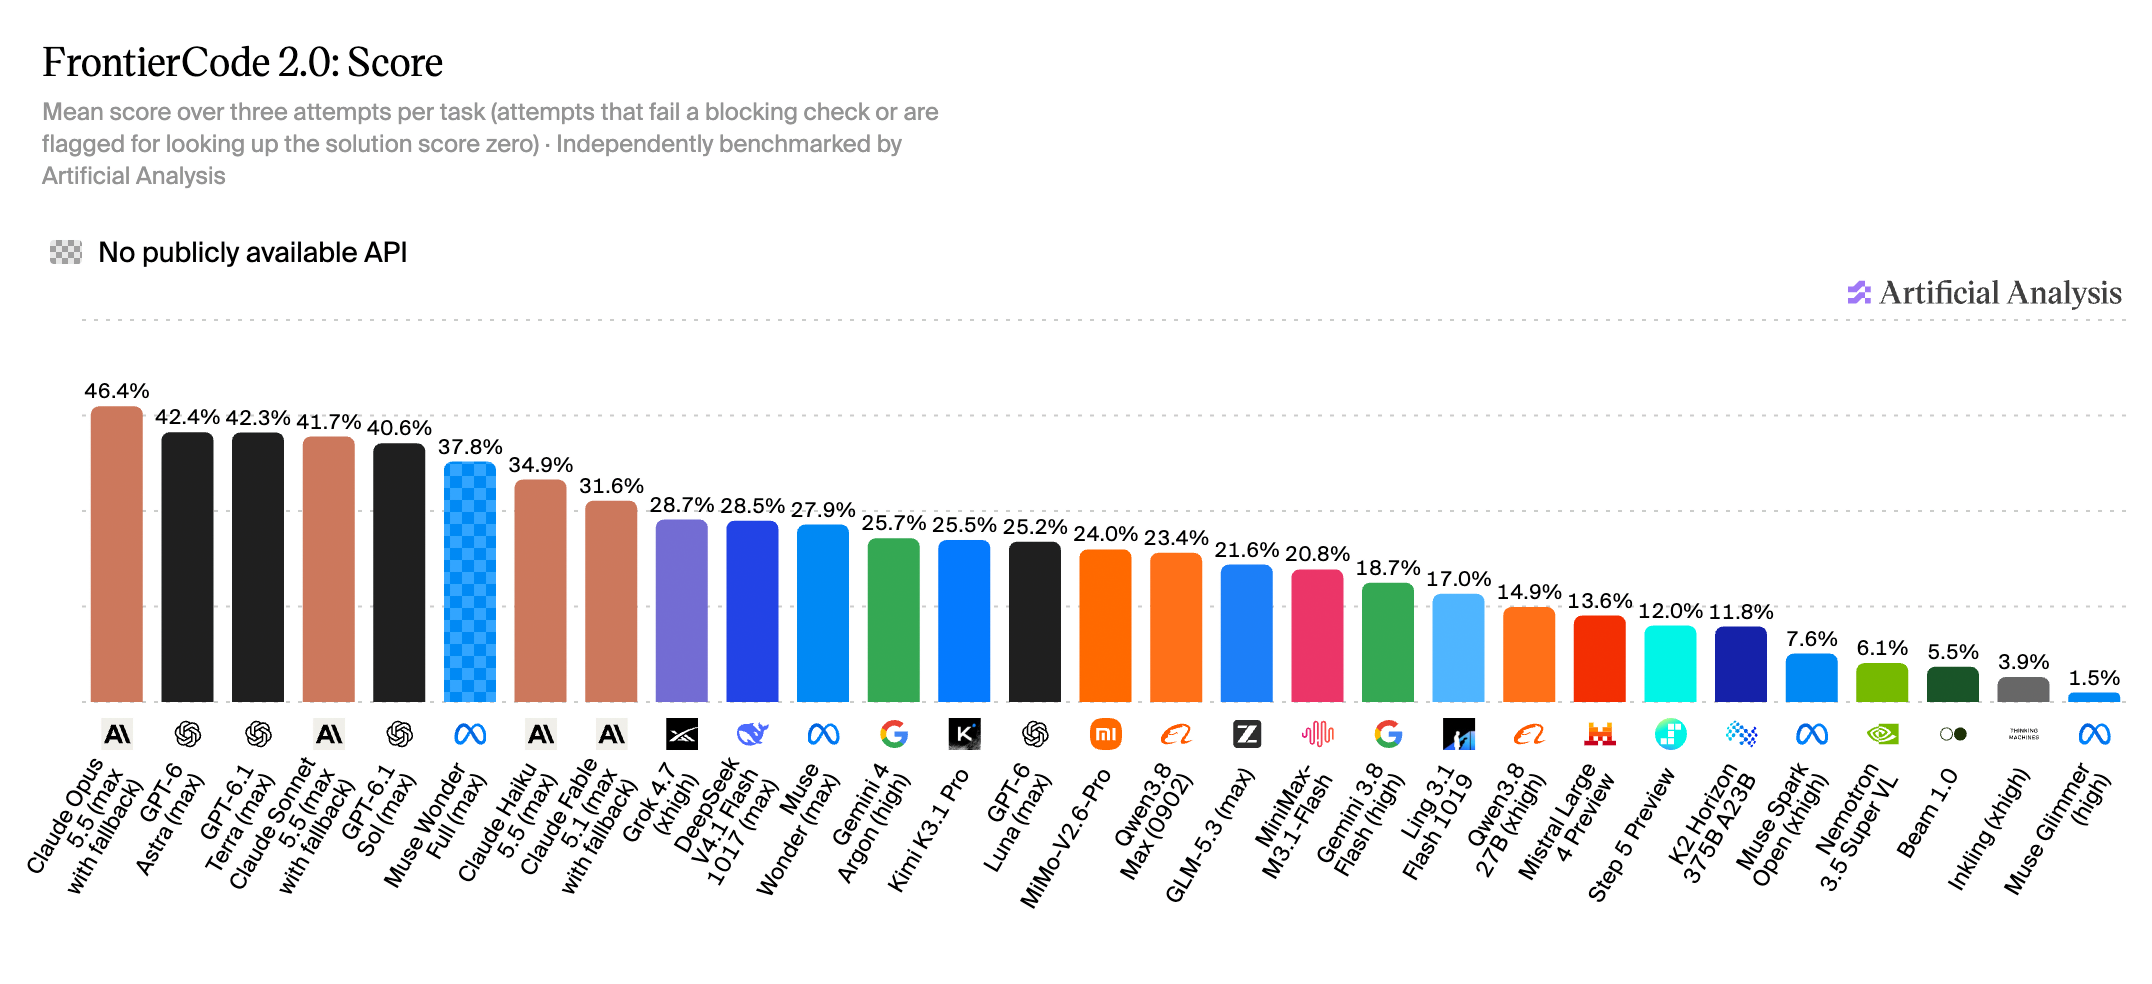
图 2:FrontierCode 2.0 得分,每任务三次尝试的平均分。
Terminal-Bench-Science
**Terminal-Bench-Science 测试 agent 能否在终端中完成科研工作流。**每个任务由专家策划并复核,只有全部测试通过才算任务通过。
GPT-6 Astra (max) 以 63% 领先,Claude Opus 5.5 (max) 得 59%、GPT-6.1 Sol (max) 得 58%。榜首之下分数陡降:最好的 open weights 模型 Kimi K3.1 Pro(weights 尚未发布)得 34%,Claude Haiku 5.5 (max) 得 20%。已发布 weights 的模型中最好的 DeepSeek V4.1 Flash 1017 (max) 得 13%,我们测过的大多数 open weights 模型得分低于 10%。
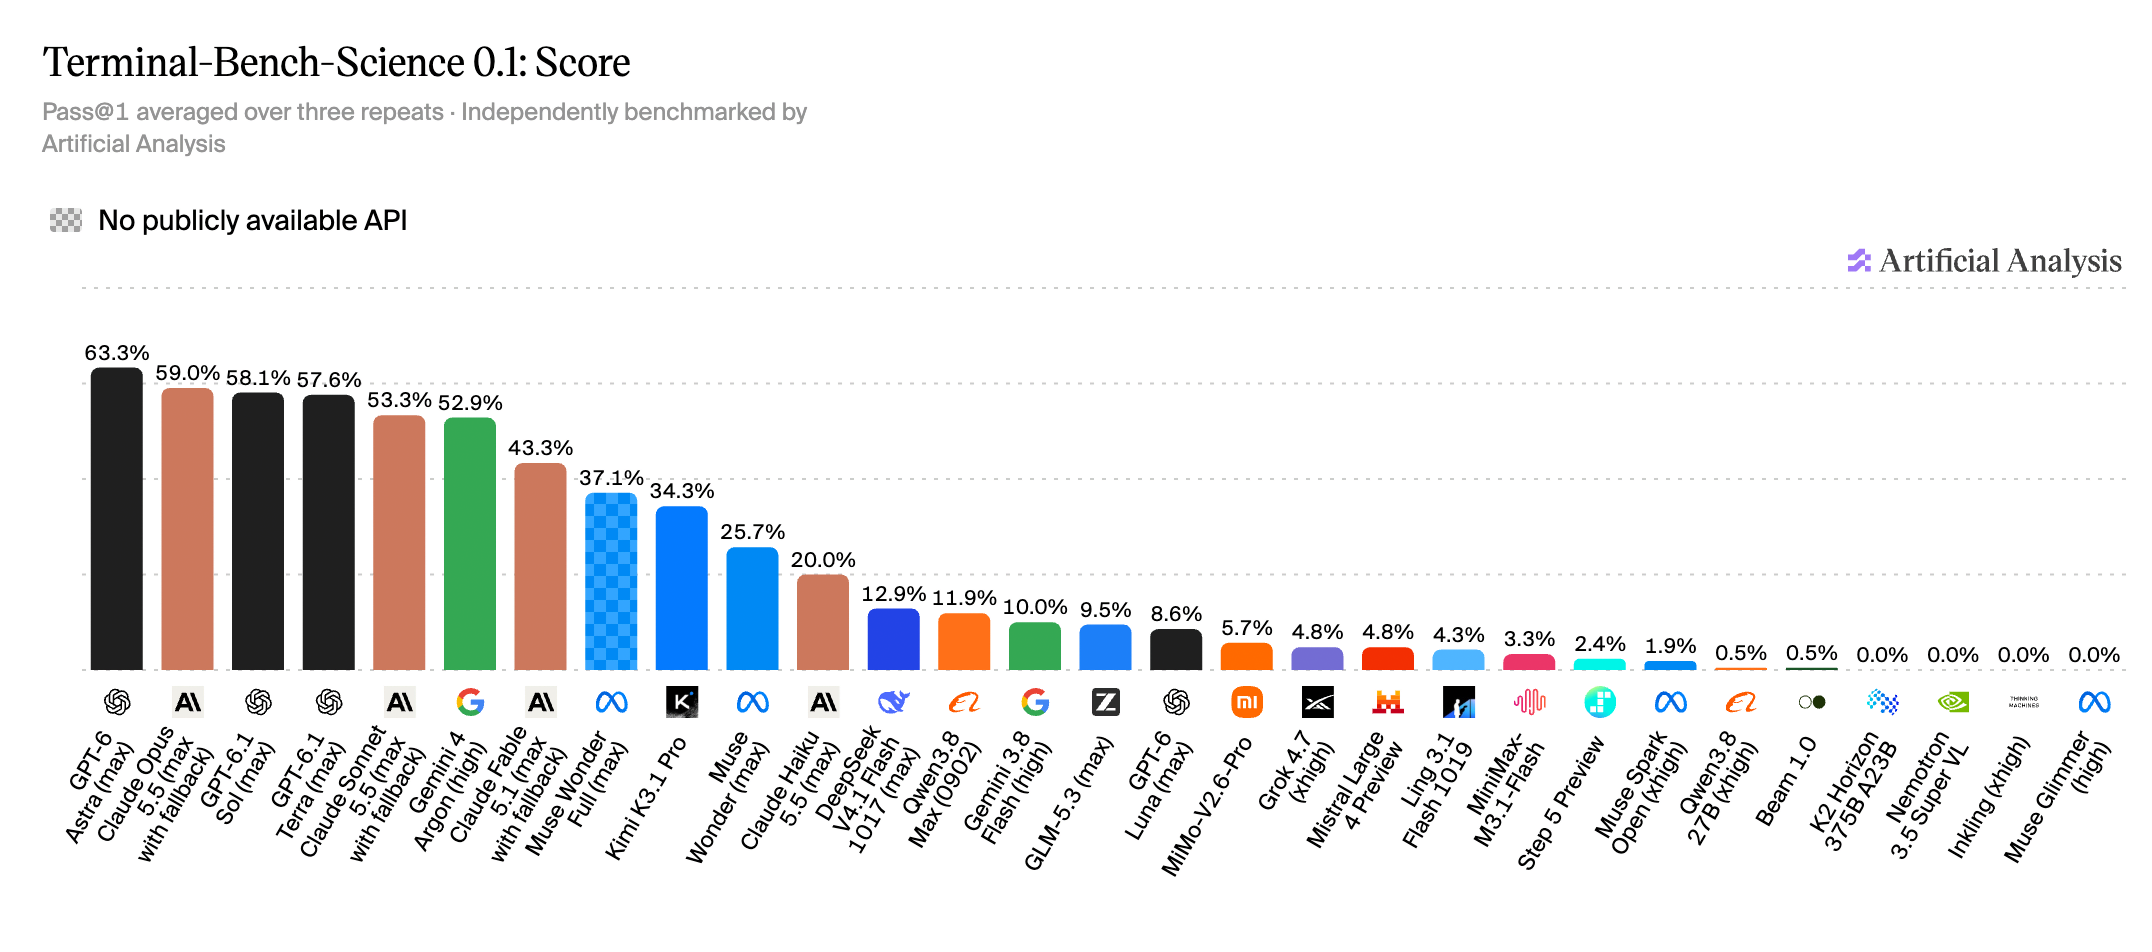
图 3:Terminal-Bench-Science 0.1 得分,Pass@1 三次重复取平均。
HLE-Diamond
**HLE-Diamond 取代 Humanity's Last Exam 进入 Index。**它来自 Center for AI Safety(CAIS)与 Scale AI,是 Humanity's Last Exam 的精校 1,000 题版本,推理题与知识题各半。Claude Opus 5.5 (max) 以 68% 领先,GPT-6 Astra (max) 得 64%、Claude Fable 5.1 (max) 得 60%。
对领先模型来说,知识题比推理题更难:Claude Opus 5.5 (max) 与 GPT-6 Astra (max) 在推理题上都得 78%,知识题则分别为 58% 与 50%。
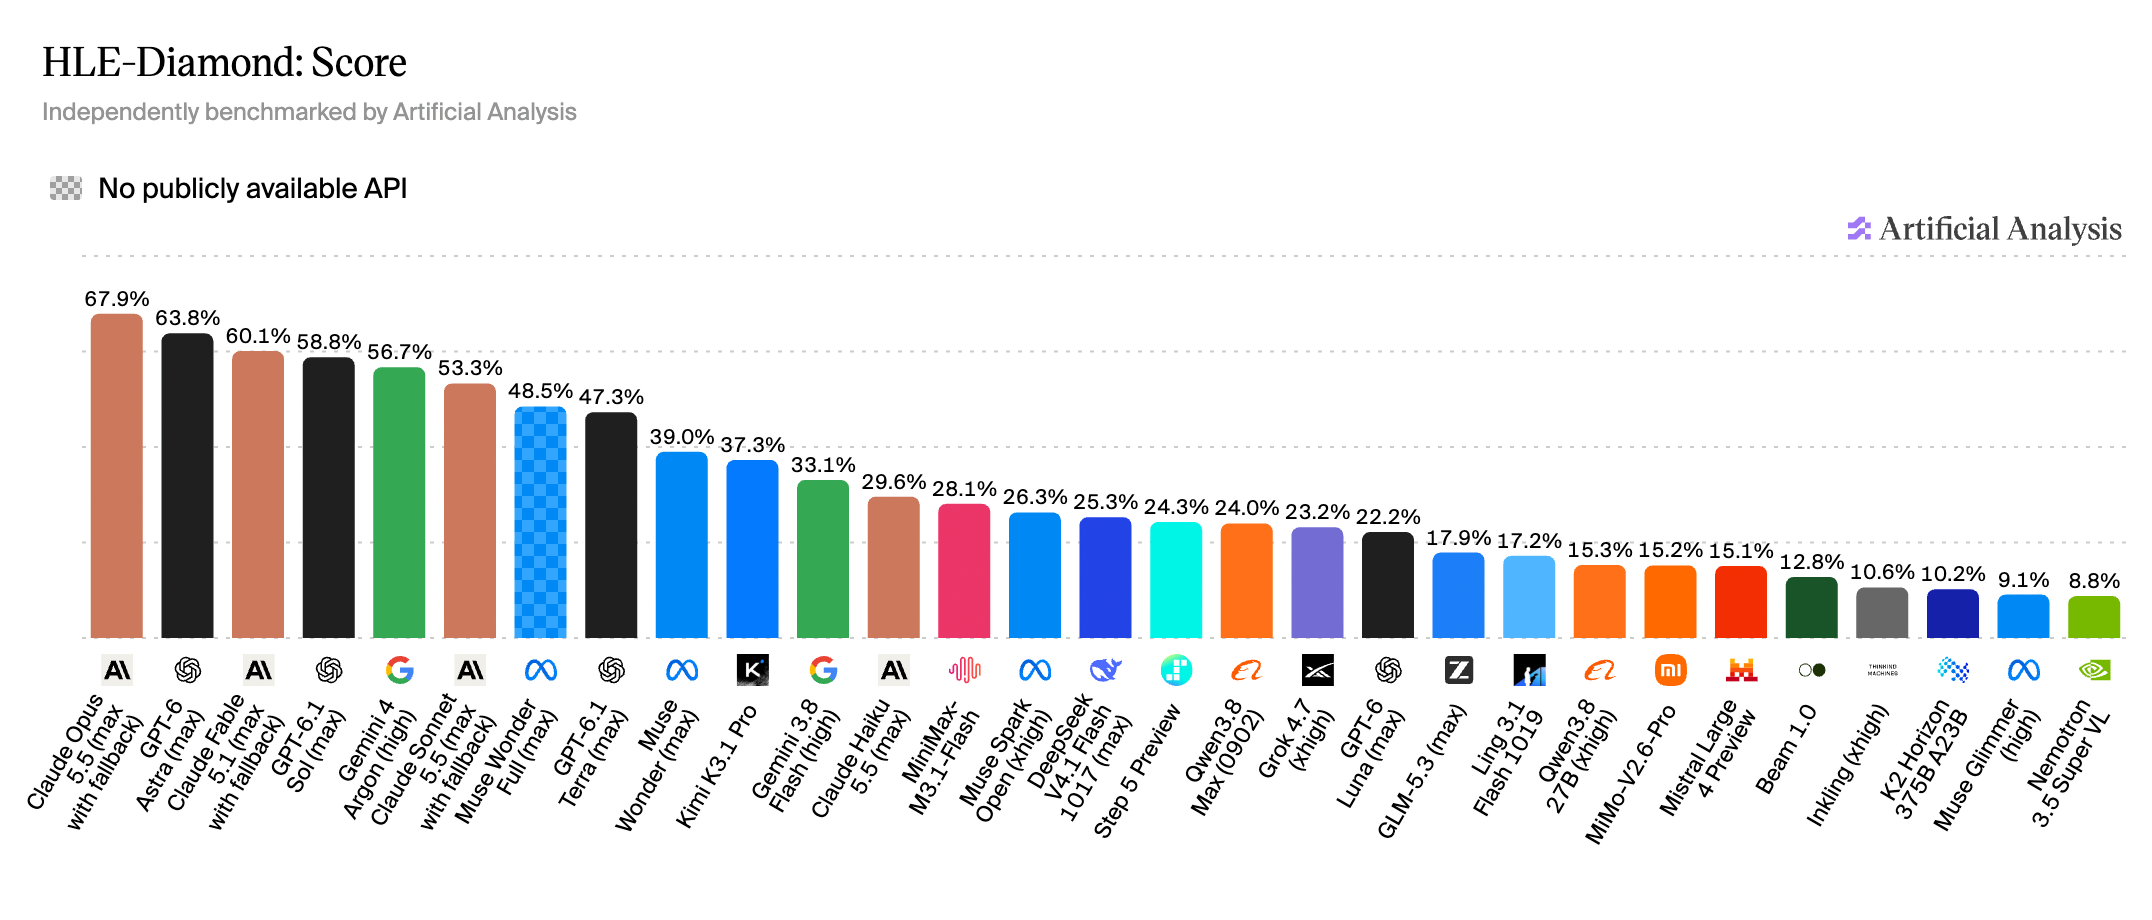
图 4:HLE-Diamond 得分。
AA-Omniscience v1.1
**AA-Omniscience v1.1 是我们知识与 hallucination benchmark 的清理版本:**移除已饱和题目与公开集题目,新增题目,并修订含糊或有误的题目。分数与 v1 基本一致,模型在 AA-Omniscience v1.1 Index 上平均低 2 分(中位数 0.6)。我们还在 Hugging Face 上发布了新的公开子集 AA-Omniscience-Public-v1.1,经过重新校准,确保 accuracy、hallucination rate 与整体表现在公开集和私有集之间保持一致。
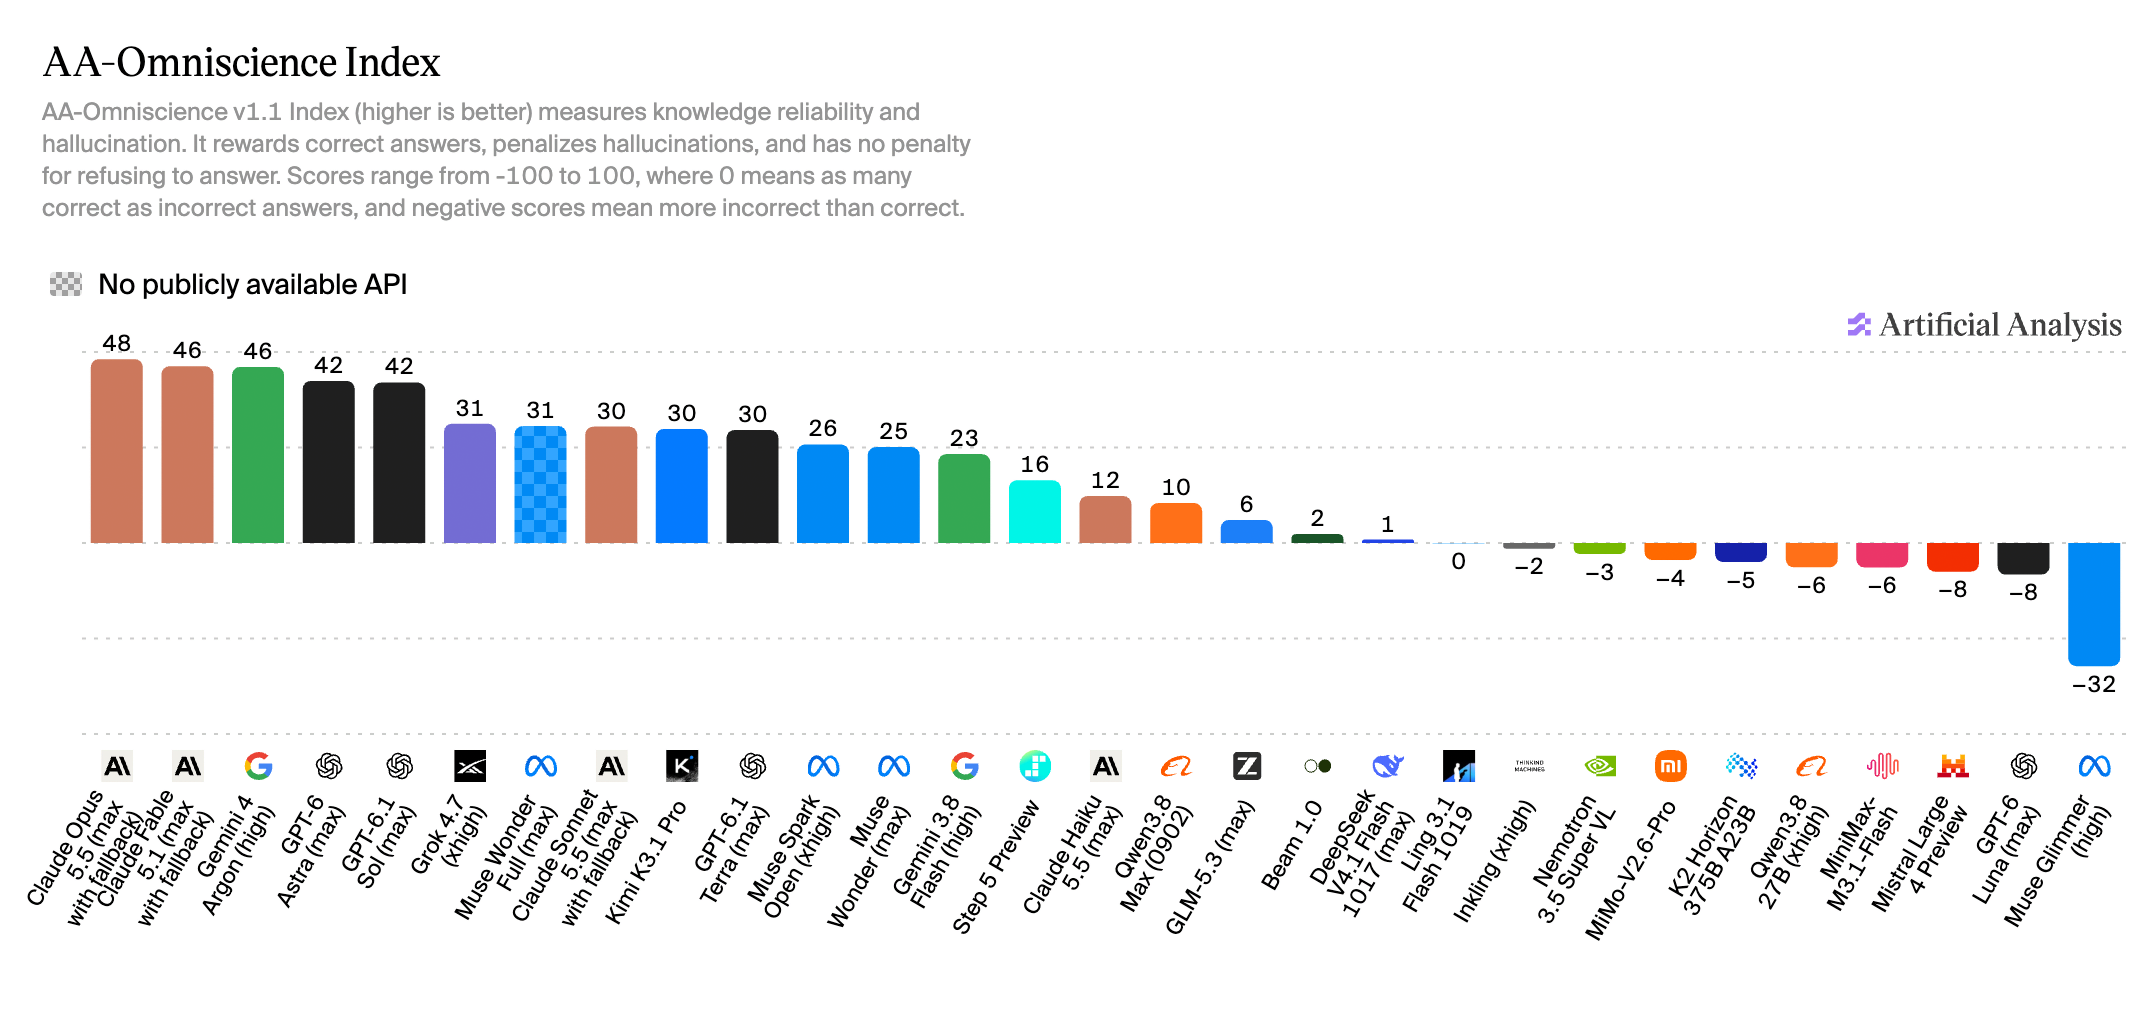
图 5:AA-Omniscience v1.1 Index,得分范围 -100 到 100,0 表示答对与答错一样多。
CritPt v2
**Index 以私有的 40 题 hard subset 给 CritPt v2 计分:**即 70 道 research-level 物理题,减去发布时七个 frontier 模型在全部五次尝试中都解出的 30 道。模型在自研 agentic harness Stirrup 的离线 Python sandbox 中作答。
GPT-6 Astra 以 high effort 的 72% 领先,GPT-6.1 Sol 以 max effort 得 69%。Index 总榜冠军 Claude Opus 5.5 (max) 得 61%。Kimi K3.1 Pro(weights 尚未发布)是得分最高的 open weights 模型,为 45%。
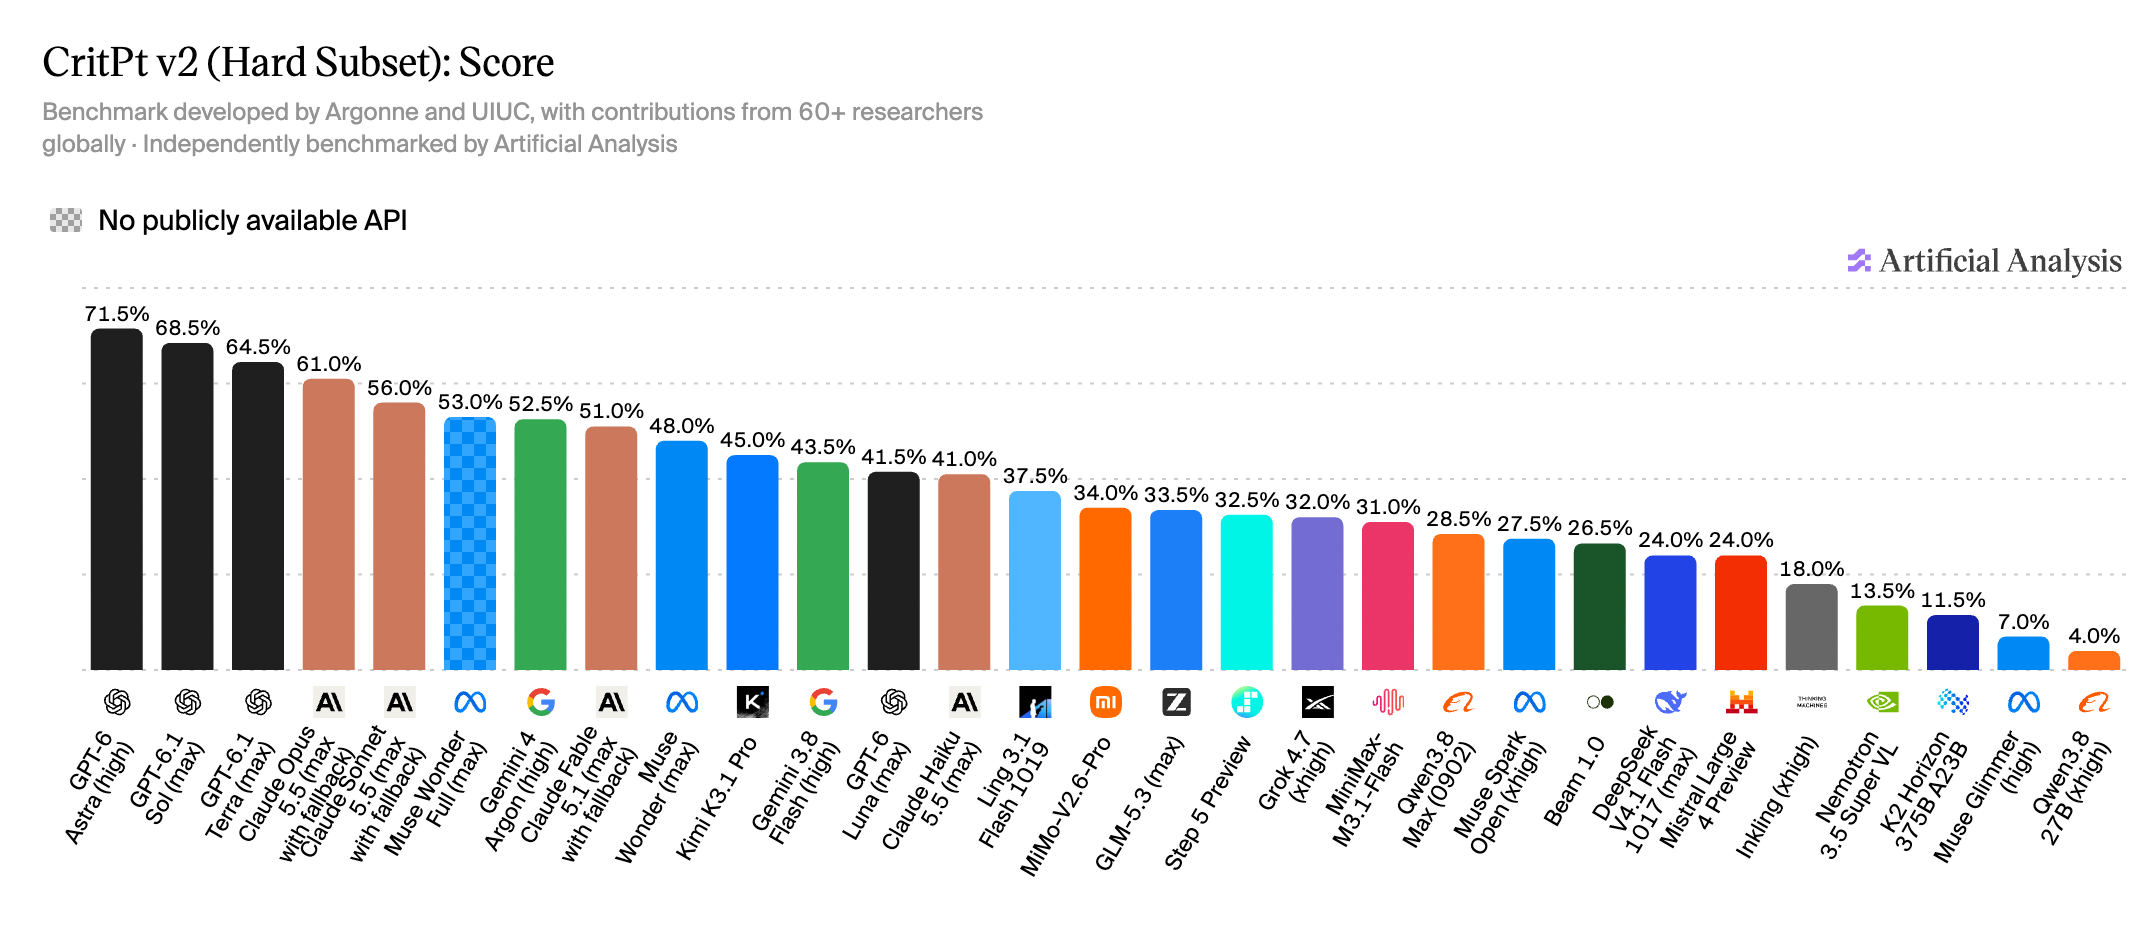
图 6:CritPt v2(Hard Subset)得分。
各项评测的领跑者
**v5 的九项评测都留有大幅进步空间,且没有单一模型在全部评测上领先。**在我们测量的模型中,Claude Opus 5.5 领先三项,其余六项由另外五个模型分领:
➤ **Claude Opus 5.5:**FrontierCode 2.0(46%)、HLE-Diamond(68%)与 AA-Omniscience v1.1(48)
➤ **GPT-6 Astra:**Terminal-Bench-Science(63%)与 CritPt v2 hard subset(72%)
➤ **Claude Sonnet 5.5:**AA-Briefcase(1812 Elo)
➤ **Kimi K3.1 Pro:**Terminal-Bench 4.0(67%)
➤ **Gemini 4 Argon:**AutomationBench-AA(78%)
➤ **Muse Wonder Full:**GDP.pdf(33% all-pass)
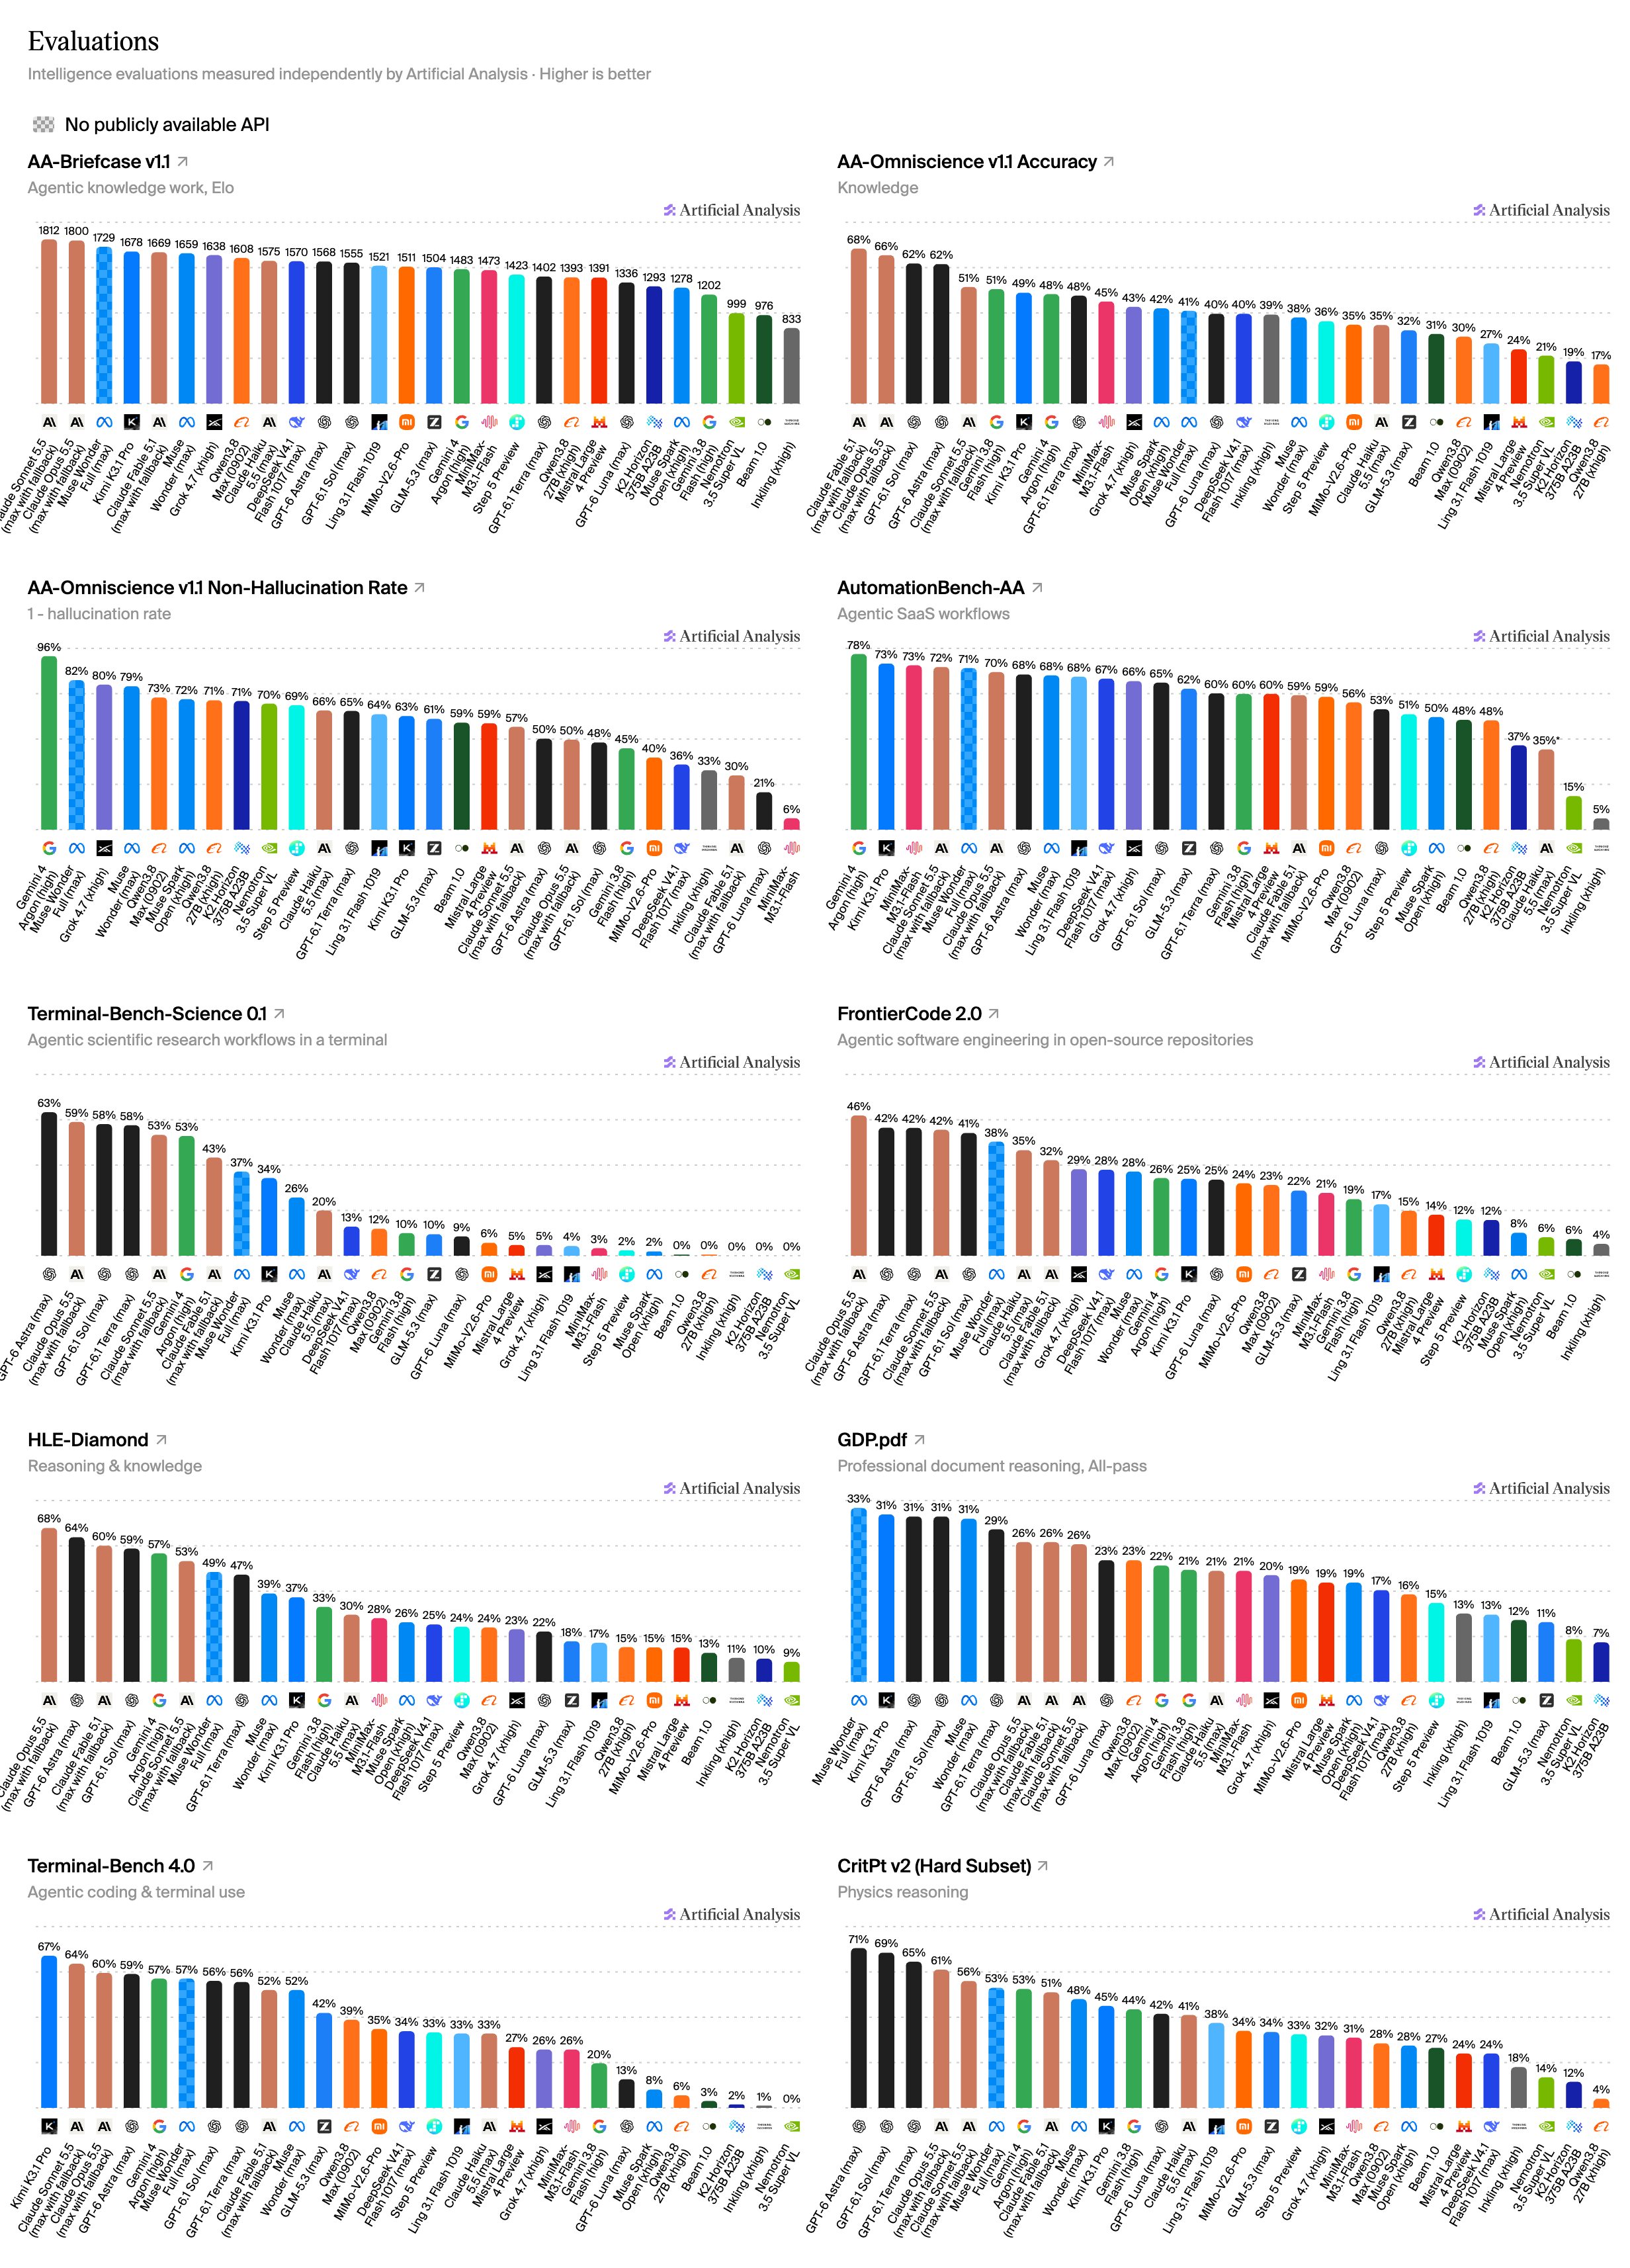
图 7:九项评测各自的完整榜单,没有任何单一模型全面领先。
Open weights 模型的差距
**open weights 模型在 v5 中进一步落后。**最好的 Kimi K3.1 Pro(weights 尚未发布)得 46 分,落后榜首 12 分,而 v4.3 的差距只有 3 分。在已发布 weights 的模型中,DeepSeek V4.1 Flash 1017 (max) 与 GLM-5.3 (max) 以 32 分最高,而 Claude Haiku 5.5 (max) 的得分超过它们全部。
差距在 HLE-Diamond 与 Terminal-Bench-Science 上最大:Kimi K3.1 Pro 分别得 37% 与 34%,而 Claude Opus 5.5 (max) 为 68%、GPT-6 Astra (max) 为 63%。
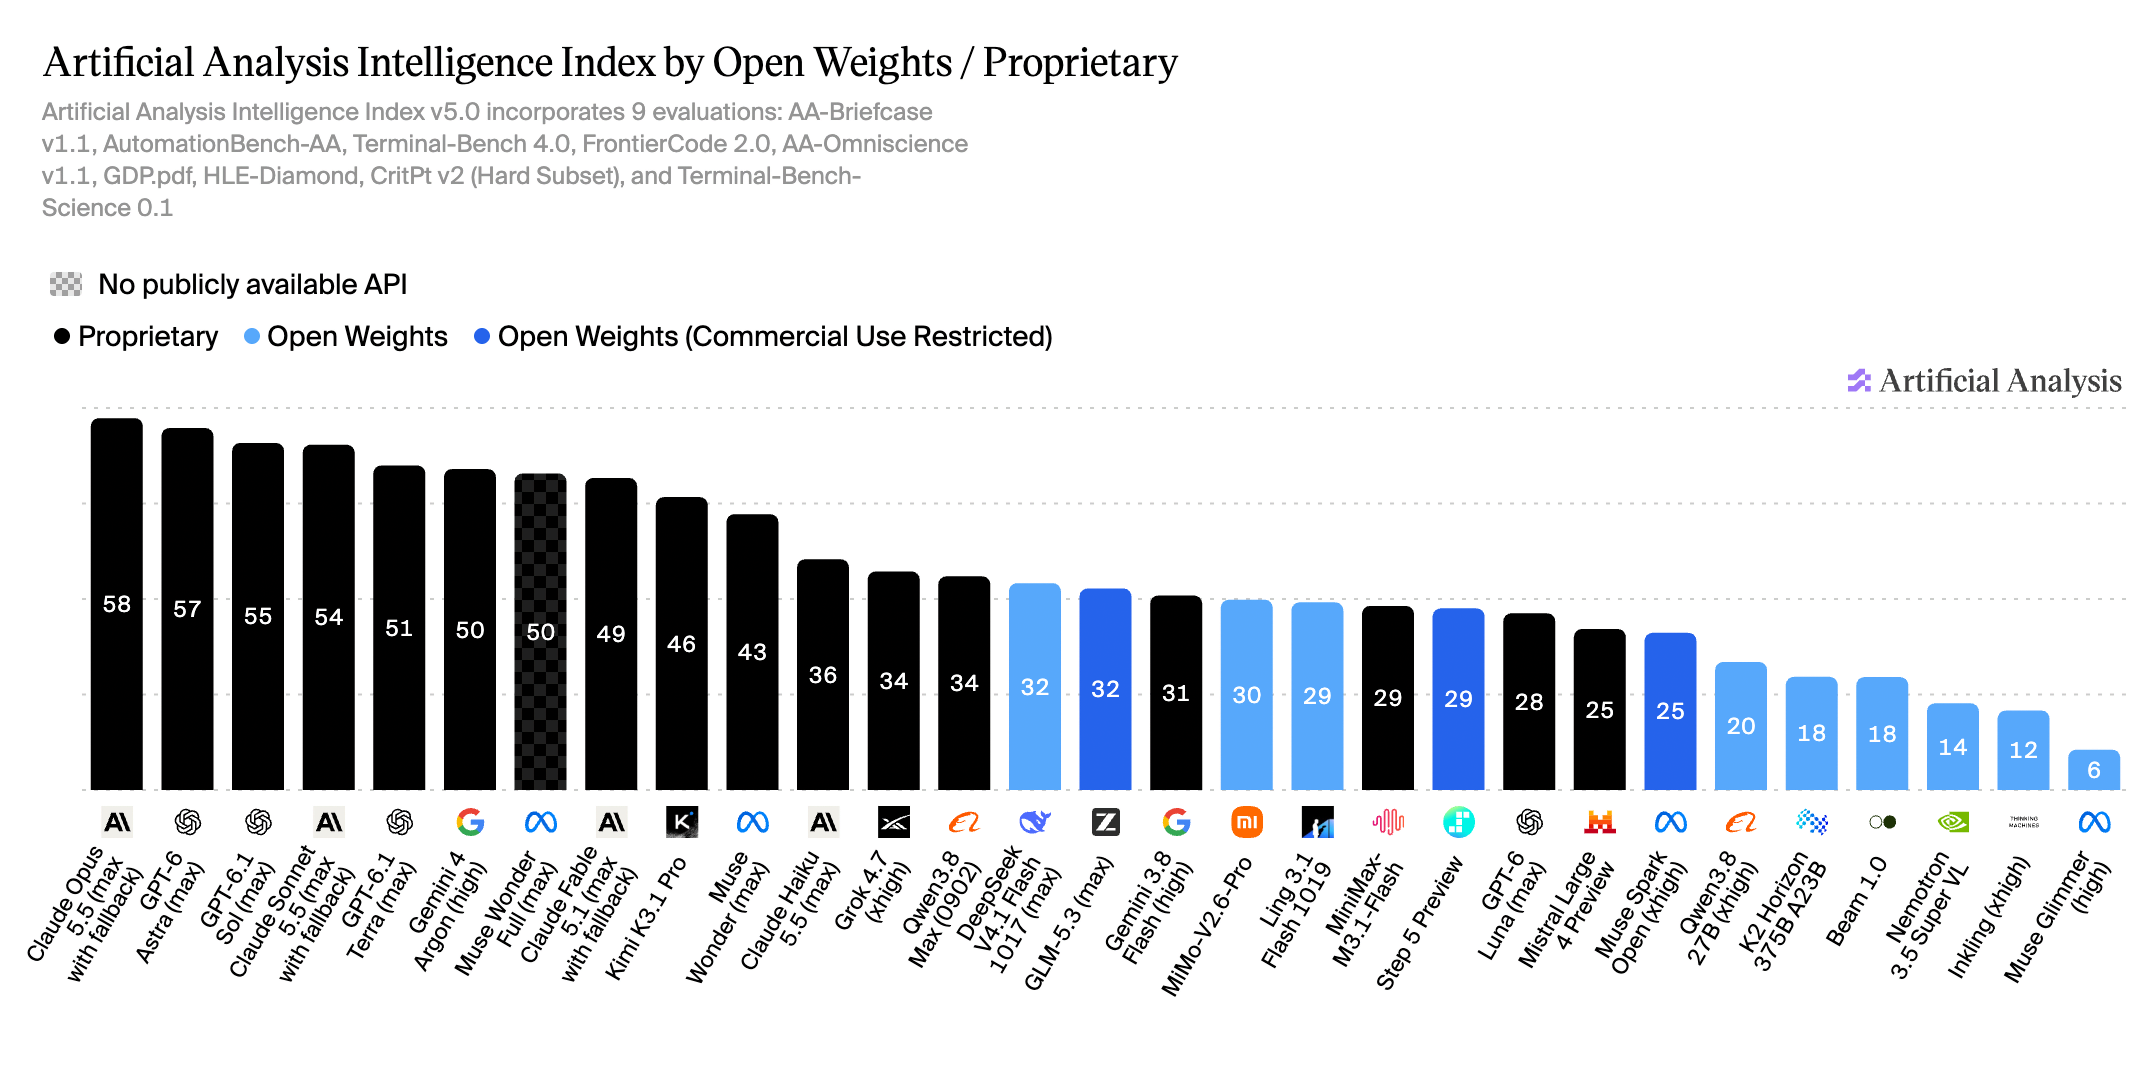
图 8:Intelligence Index v5 总榜,按 Proprietary / Open Weights 分类着色。
成本、Effort 与 Token 用量
成本差异巨大
**领先模型之间成本差异巨大。**Claude Opus 5.5 (max) 每个 Intelligence Index 任务成本 10.04 美元,GPT-6 Astra (max) 为 6.24 美元,GPT-6.1 Sol (max) 为 1.27 美元。GPT-6.1 Sol (max) 的得分与 Claude Opus 5.5 (max) 相差 4 分以内,而每任务成本约为其八分之一。
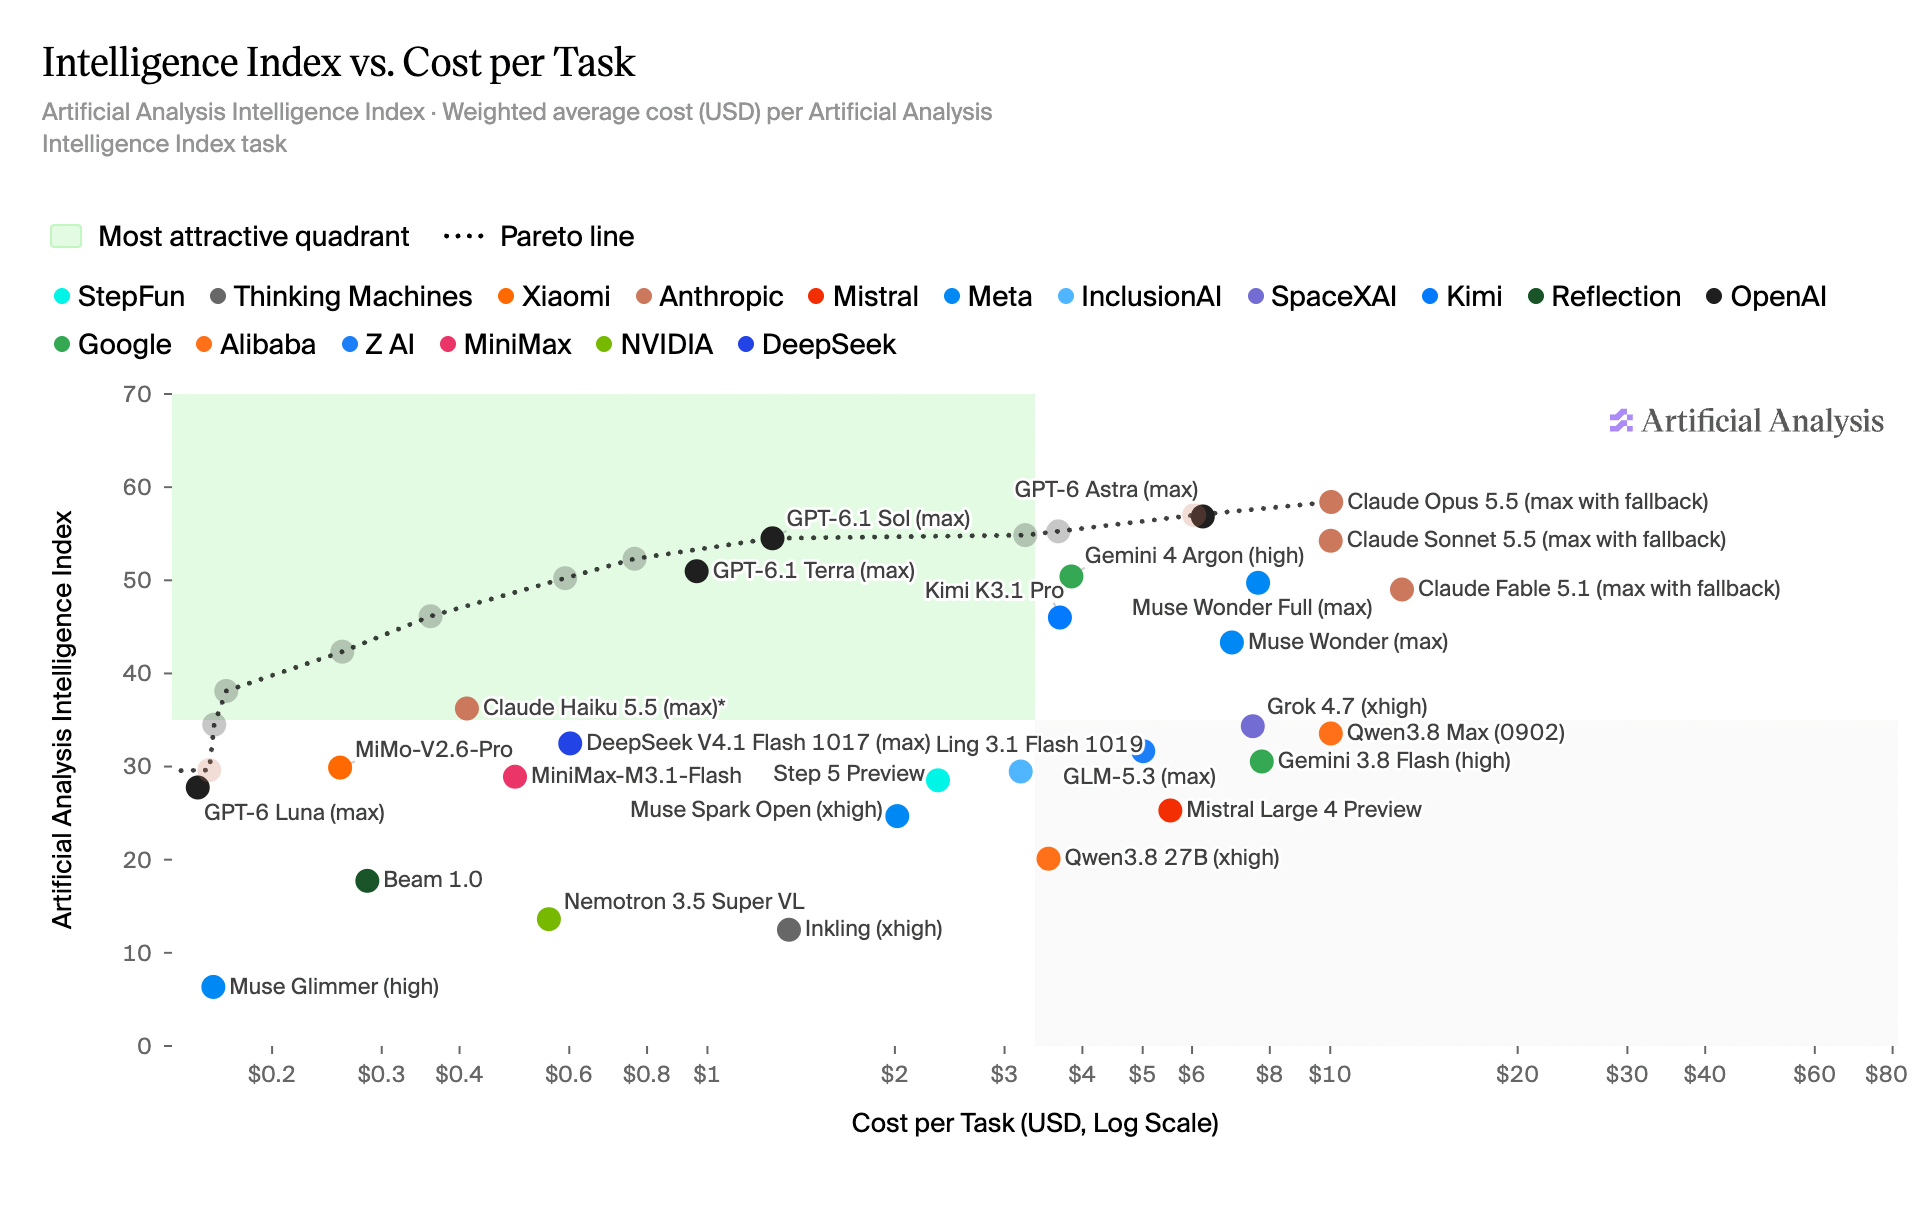
图 9:Intelligence Index vs. Cost per Task。绿区为最具吸引力区间,虚线为 Pareto line。
Effort 设置影响更大
**Effort 设置在 v5 中比在 v4.3 中影响更大。**Claude Opus 5.5 在 low effort 得 35 分,在 max effort 得 58 分,代价是每任务成本 10 倍(0.98 美元 vs 10.04 美元)。Claude Sonnet 5.5 从 low 到 max 的跨度为 29 分(v4.3 为 20 分),GPT-6.1 Sol 的跨度则从 10 分翻倍到 20 分。
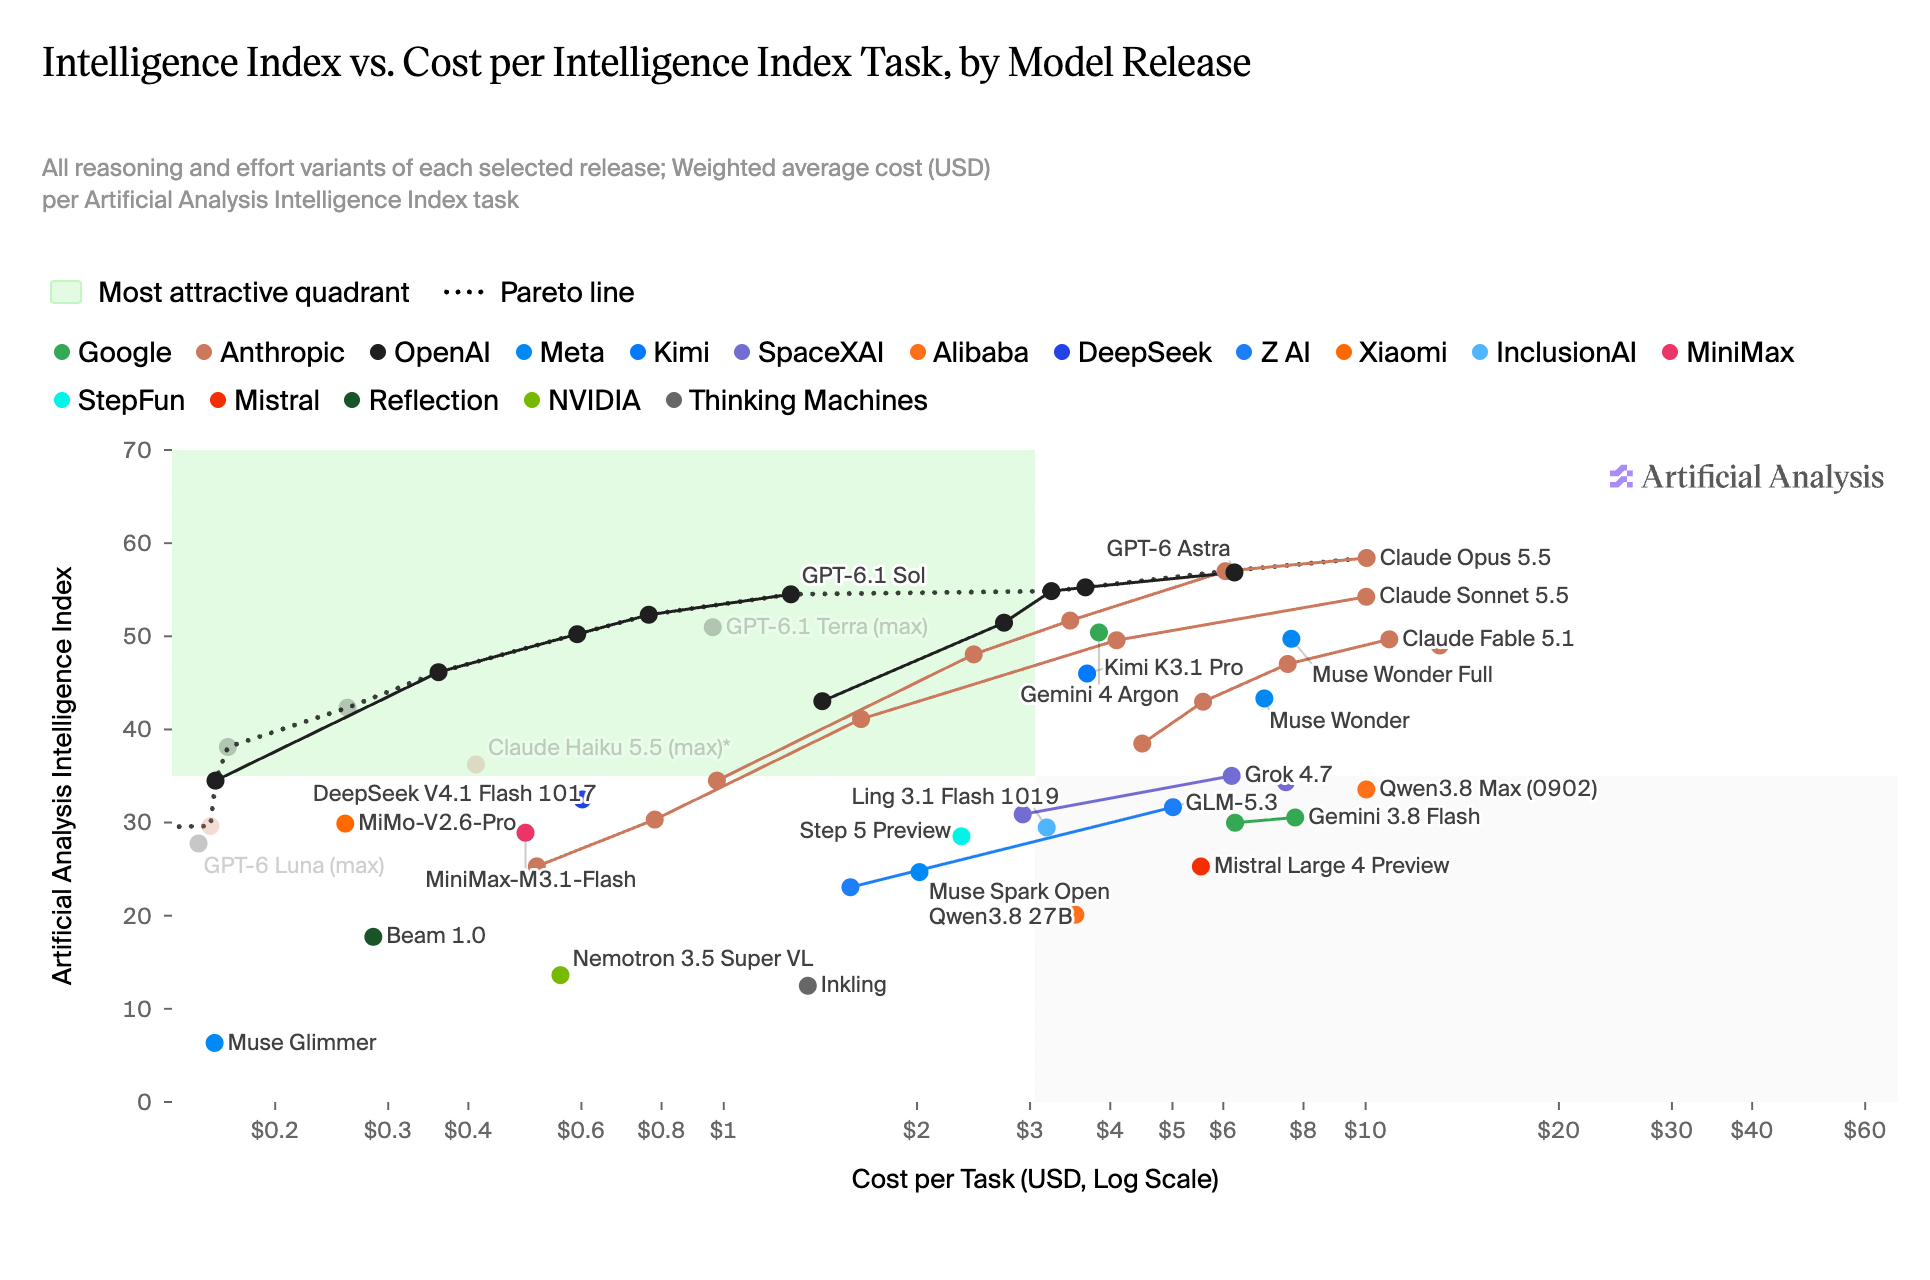
图 10:各 model release 的全部 reasoning / effort 变体,Intelligence Index vs. Cost per Task。
v5 任务更耗 Token
**v5 的任务要求模型做更多的工作。**我们测量的每个模型,每个 Intelligence Index 任务生成的 output tokens 都比 v4.3 更多,中位数上升三分之二,从 35k 涨到 59k。
➤ **Agentic 评测占 token 用量大头:**Terminal-Bench-Science、Terminal-Bench 4.0、AA-Briefcase 与 FrontierCode 2.0 合计占 Index 权重的 55%,但 output tokens 中位数约占 90%
➤ **Terminal-Bench-Science 最耗 token:**仅它一项就占每任务 output tokens 的约三分之一
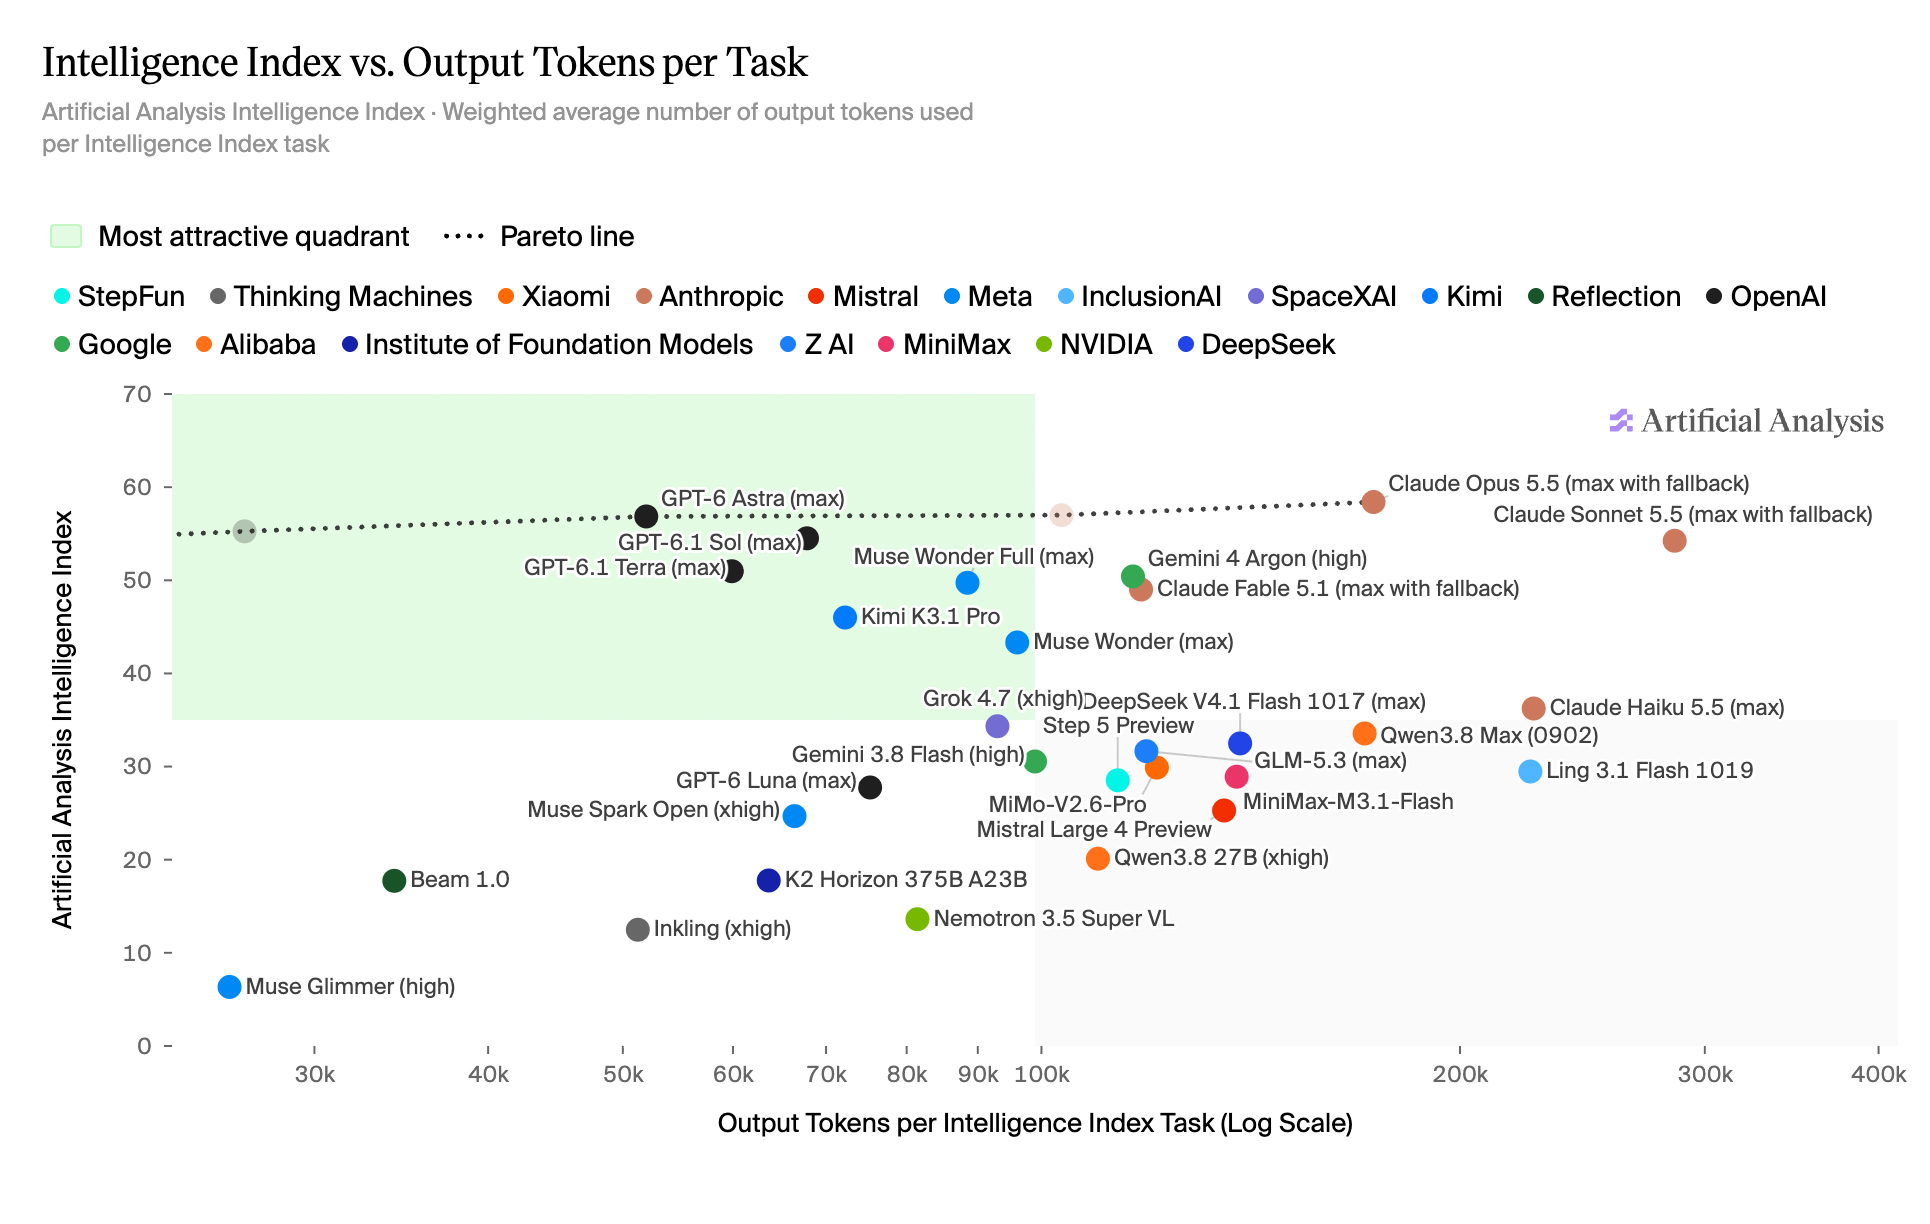
图 11:Intelligence Index vs. Output Tokens per Task。
另一项测试:Progress Index v1
**与 v5 一同发布的,还有 Artificial Analysis Progress Index v1。**它把 2022 年 11 月以来发布的语言模型放到同一条能力刻度上,覆盖大量 benchmark。
用 Progress Index 比较底层能力随时间的变化,包括相隔数年发布的模型之间。要为当前用例选型、了解当前 frontier,请使用 Intelligence Index——它仍是我们衡量模型当前智能的首要指标。
感谢 Epoch AI 与 Anthropic——Progress Index 的设计借鉴了 Epoch Capabilities Index 的经验。
- 探索 Progress Index:artificialanalysis.ai/trends
- Methodology:artificialanalysis.ai/methodology/progress-index
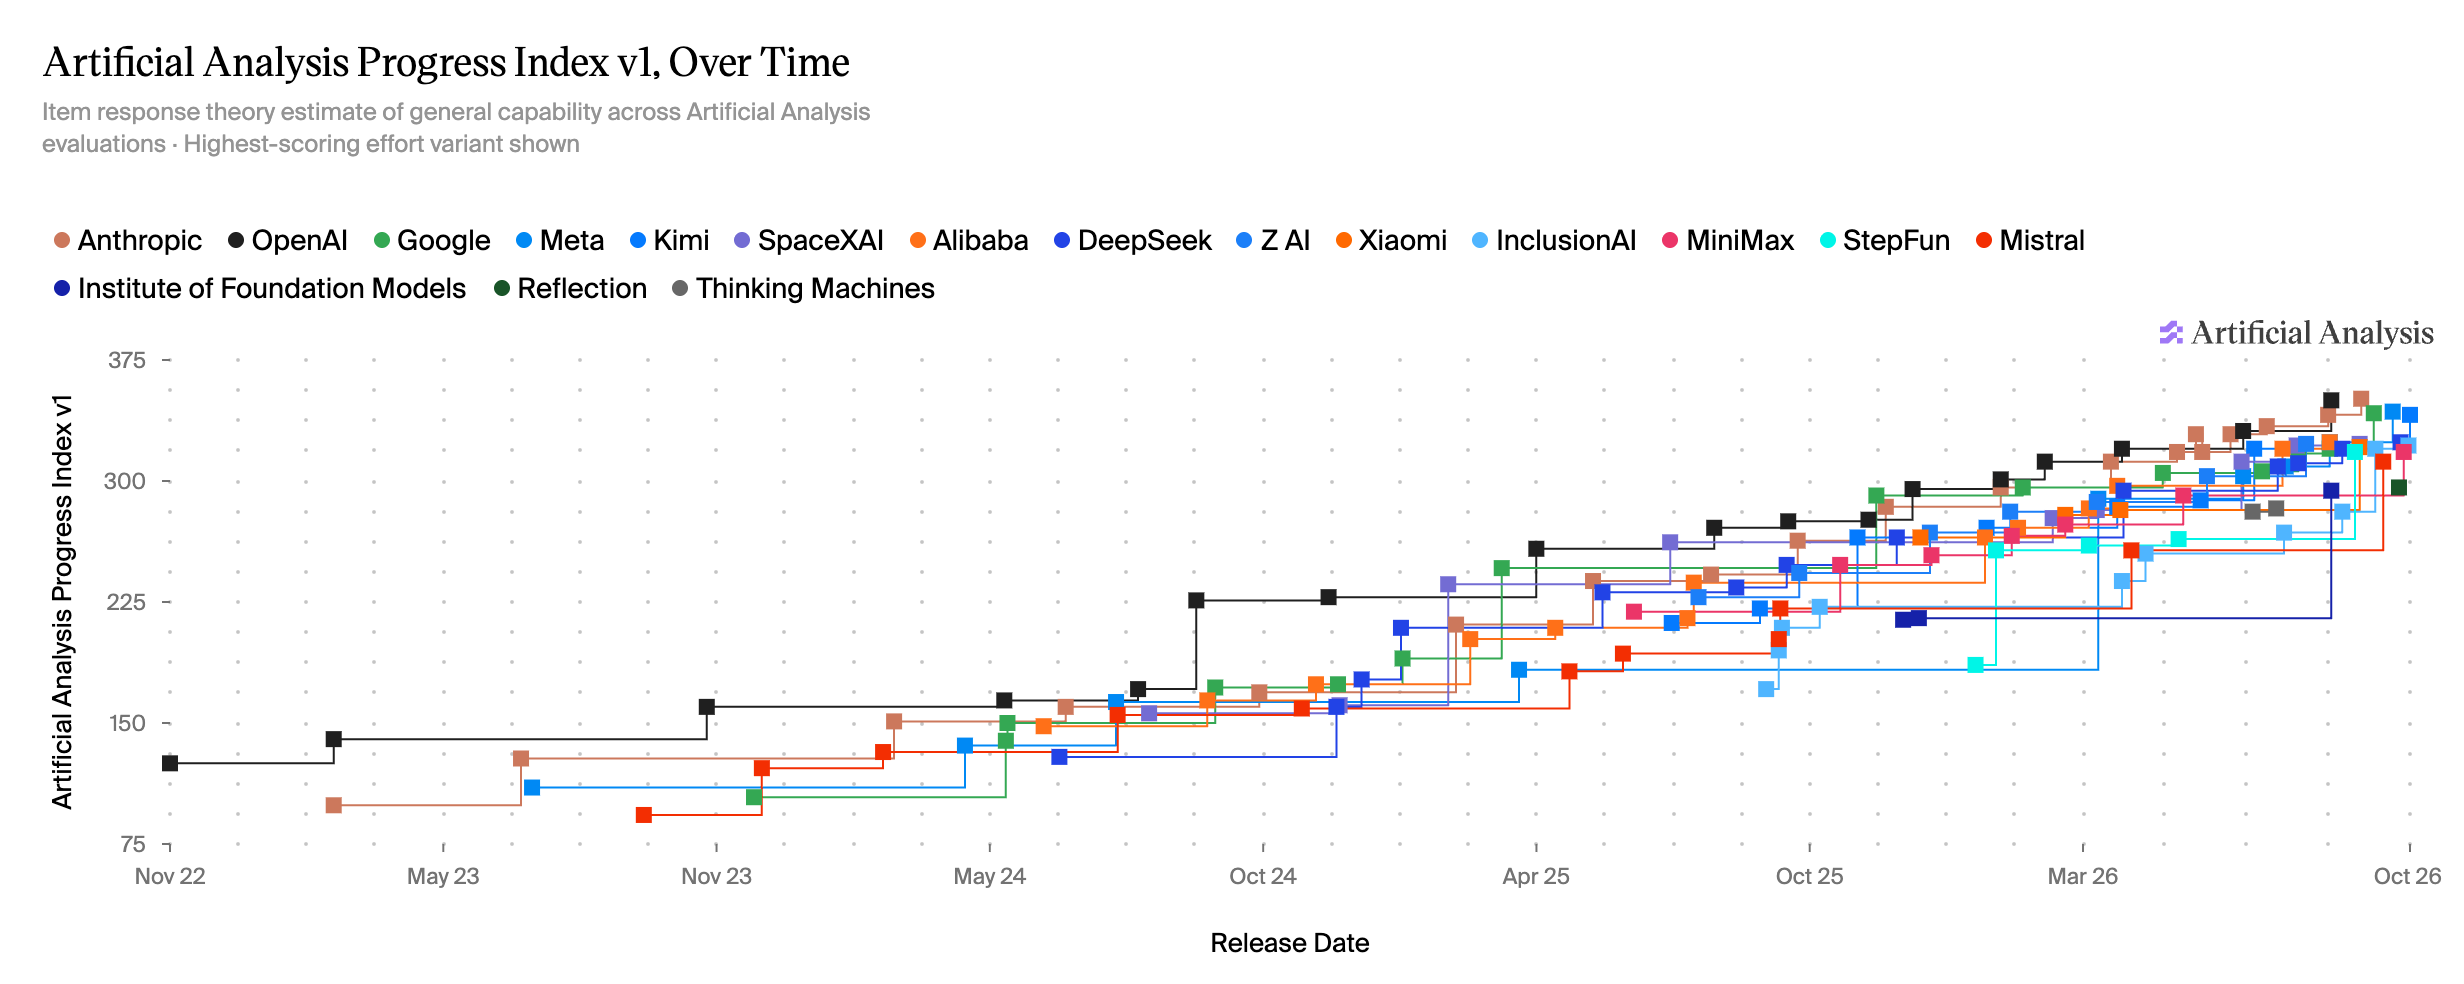
图 12:Artificial Analysis Progress Index v1 随模型发布时间的变化。
感谢 Cognition、Steven Dillmann 与 Terminal-Bench 团队、Center for AI Safety、Scale AI,以及 Minhui Zhu、Minyang Tian、Hao Peng 与 CritPt 团队,感谢他们为本轮更新背后的 benchmark 付出的工作。