Jev 玩不好扫雷,那它擅长什么?读懂 Decision Index
从 Jev 扫雷失败出发,介绍 Decision Index 0.3.2 文本榜的评测方法、五个能力领域、概率校准与响应延迟,并说明如何按自己的任务读榜选型。文章结合 ChessBench 低分解释扫雷失败原因,建议优先接入工具选择、检索分类等强项,弱项先放一放,等待模型迭代。
展开文章目录
我让 Jev 玩了扫雷。简单难度有时能够通关,也经常踩雷。结论是:Jev 1.13 或 1.14用来扫雷,目前还比较勉强。(更新:10月15日,Jev 1.14 已出,第一时间测试,发现效果基本没变)
上一篇文章介绍了 Jev:把状态和问题交给模型,直接拿到程序可以使用的结构化决策。既然它能快速选择行动,我就想试试,能不能让它选择扫雷的下一步?
实验的思路很直接:读取棋盘,把未揭开的格子作为候选项,请 Jev 选择下一步,再由程序实际点击。模型拿到的是文本表示的棋盘和候选信息,并不需要先识别游戏截图。
下面是保留下来的一次失败画面。右侧记录显示,模型实际版本为 jev-1.13.0,第 23 步选择了 (7,7),置信度为 0.07,随后游戏结束。
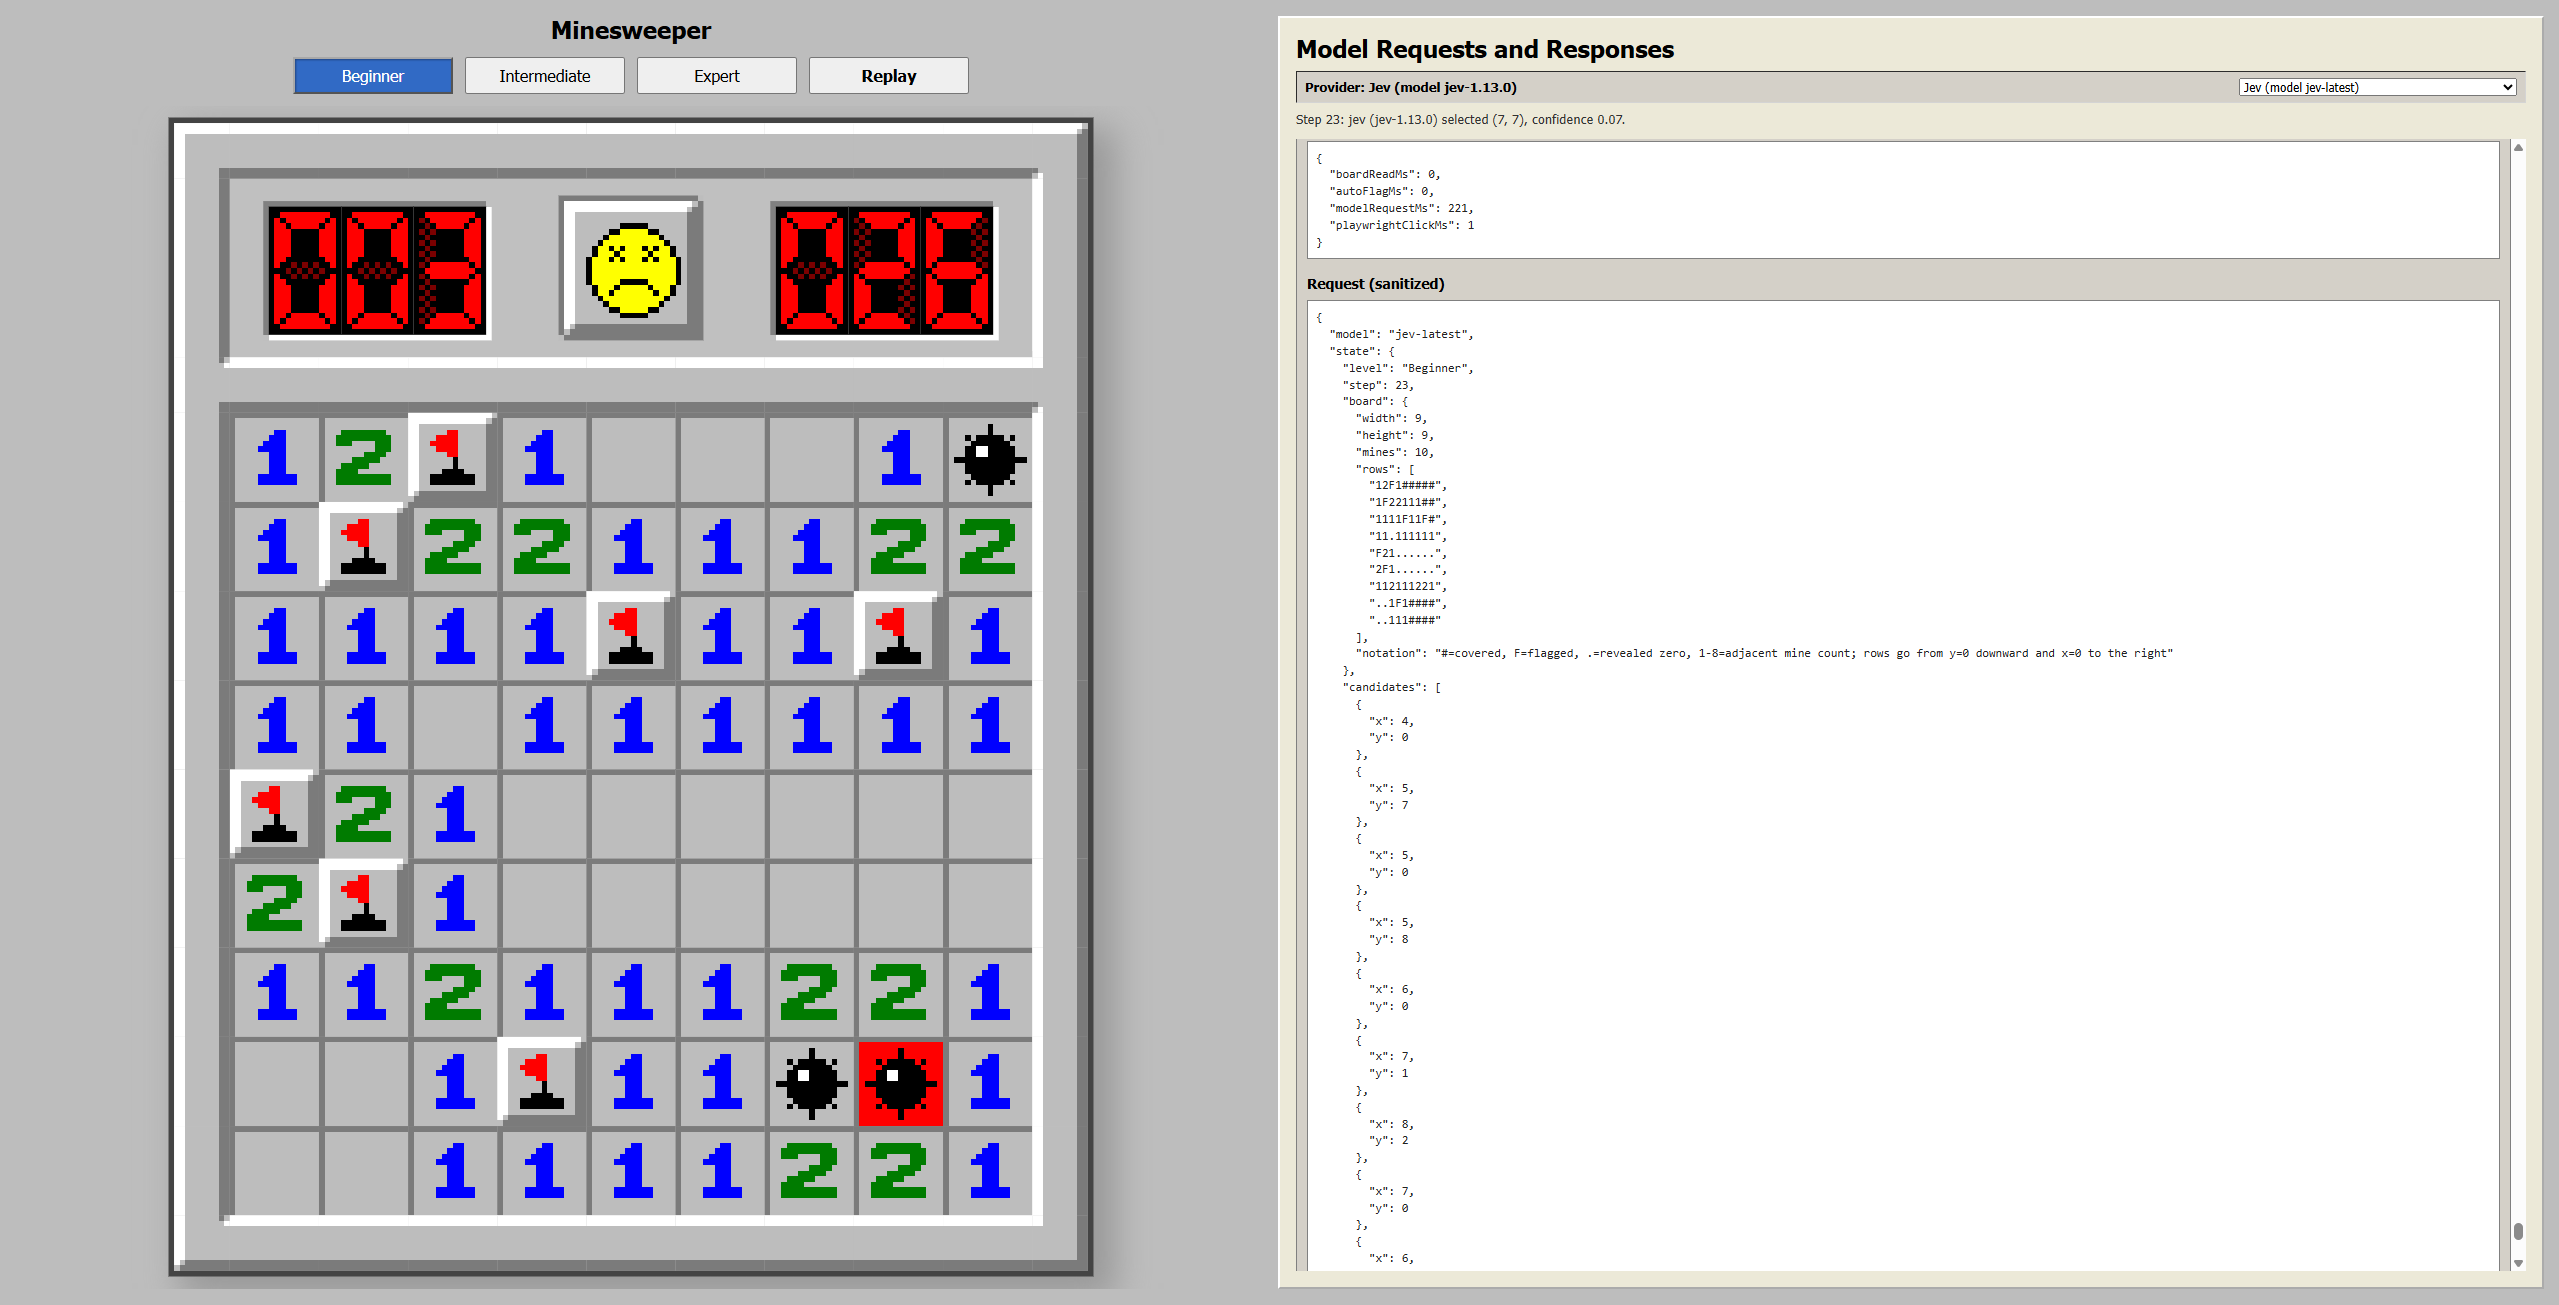
图 1:扫雷的失败截图。
扫雷这种游戏,一步踩错就结束了。反复踩雷表明:这个版本的能力还没到位,先放一放。但这也让我开始追问:Jev 到底强在哪里,弱在哪里?哪些任务值得接入,哪些应该先放一放?
后来,我在 GitHub 的讨论中看到了 Decision Index(简称 DI)——一份比较结构化决策能力的社区评测。它给了我一个继续寻找答案的入口。
这篇文章就从这次失败出发,看看 DI 测了什么,怎样按自己的任务读榜,以及能力、概率校准和速度这三个指标能怎样帮助我们选择模型。扫雷的详细请求分析和运行方法放在后面,想深入研究的读者可以继续看。
DI 是什么,为什么值得看?
Decision Index 提供了一个可参考的能力地图。它是社区建立的评测,网站明确标注与 TypeSafe AI 没有关联,比较 Jev 与开源复现方案在结构化决策任务上的表现。
对使用者来说,它的价值是把“这个模型好不好”拆成更具体的问题:哪些任务做得好,答案的概率是否可信,响应能否满足应用需要。
本文采用 2026 年 10 月 14 日采集的 0.3.2 文本榜,网站数据更新时间为 10 月 14 日(北京时间 17
)。该榜列出 165 个开放复现条目和 Jev 参考模型,共 166 个条目,涵盖不同模型、微调方法和推理方案。开源进展,比我预期的快
最初关注时,我只注意到一个明显高于 Jev 的模型。隔了两天再看,又看到了两个更高的方案,榜首已经到了 66 分左右。短短两天,竞争格局就变了。这个领域的开源进展,比预期的快得多。
当前快照中的主要成绩如下:
| 模型或方案 | Full score |
|---|---|
| vLLM-SR d3(27B) | 66.26 |
| linne-oak 1.0(31B) | 65.61 |
| Decider 31B(NVFP4) | 64.62 |
| Sieve 31B | 63.81 |
| Bobcat 1.3(31B) | 62.83 |
| Perplexity Decider v1.1(27B) | 62.75 |
| Darwin-27B-ZTC | 62.46 |
| Jev 1.13.0 | 60.11 |
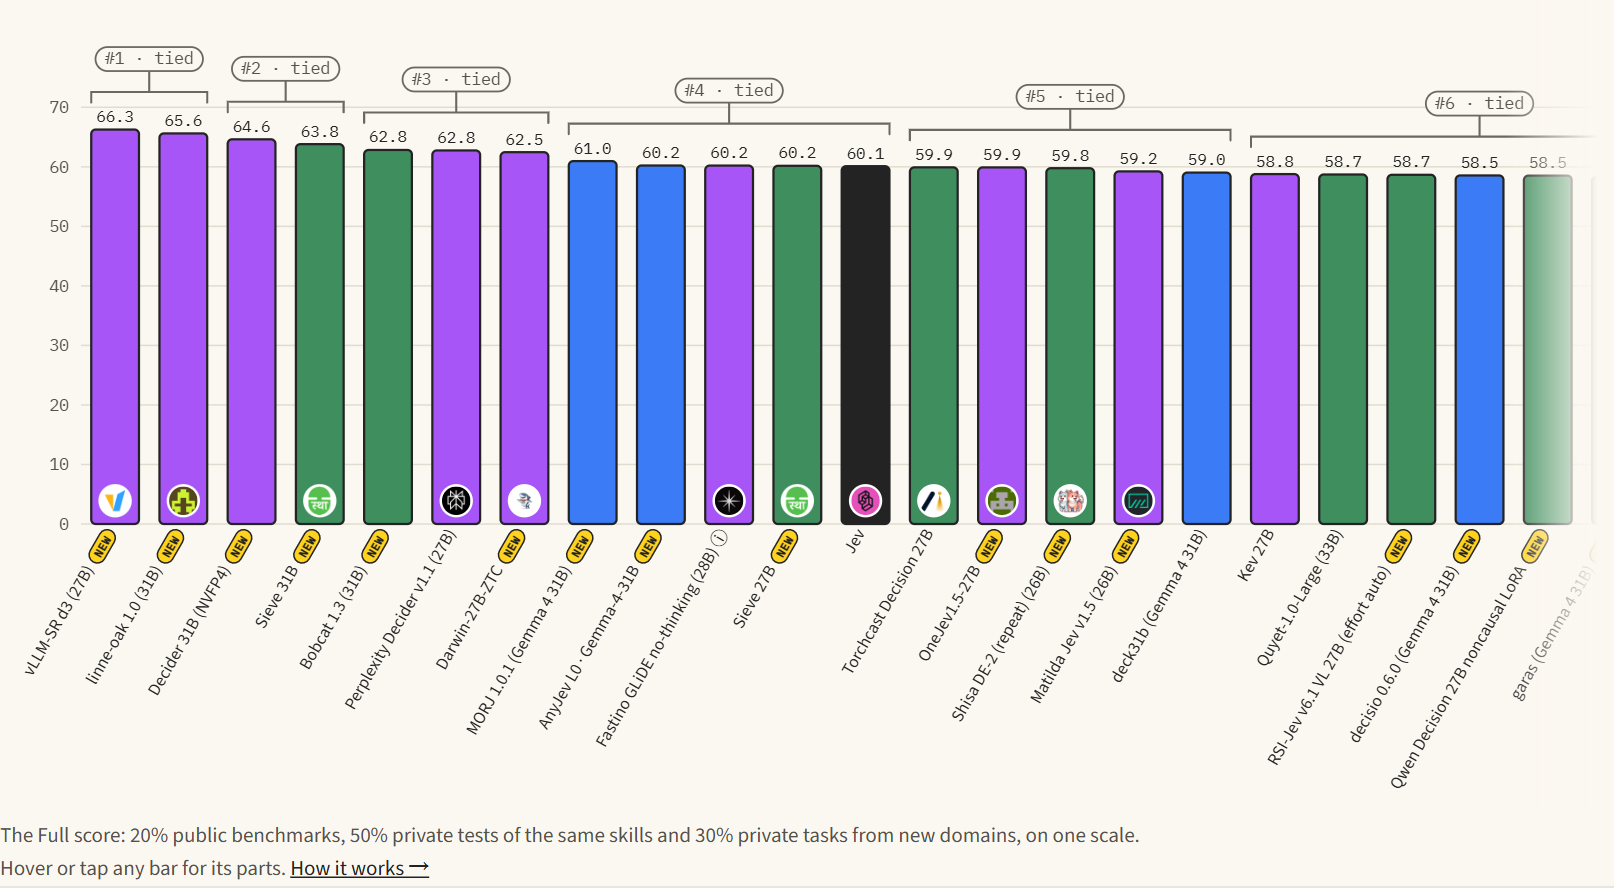
图 2:0.3.2 综合榜的得分分布,开源方案已经占据前排。
66.26 比 60.11 高 6.15 个指数分,指数得分相对高出约 10.2%。在一个刚兴起的领域,开源这么快就把领先幅度拉到了一成,很值得关注。
榜单把差距很小的条目放在同一并列组。真正吸引我的,是榜首已经与 Jev 拉开了明显距离,而且前面有多个团队的方案。
更重要的是,榜首不再由单一先发模型占据。多个团队沿着不同路径进入同一个领域,让“快速、结构化、带概率的决策”迅速成为可以竞争的能力。
这个分数,究竟测了什么?
根据网站的评分方法,0.3.2 的主要排名采用 Full score:
- 20%:公开基准。 37 项公开任务,分布在五个能力领域。
- 50%:相同能力的私有测试。 检查模型能否在未公开的同类题目上维持表现。
- 30%:新领域的私有任务。 检查能力能否迁移到公开榜单之外。
私有部分通过未微调的参考模型映射到公开分数尺度后,再参与加权。公开任务先扣除随机猜测基线,再归一化;未回答或不支持的请求算错。因此,60 分不是“答对了 60% 的题”,综合分也不是五个雷达图分数的简单平均。
我喜欢这个设计:它降低了只针对公开题库优化的收益,把“换一批题是否还能做对”纳入主要排名。80%题由测试方持有并进行测试,排除了作弊的可能,也更能展示被测模型的真实能力。
想做什么任务,就看什么分项
总分适合快速比较,分项更适合回答“能拿它来做什么”。读 DI 时,我建议先带着自己的任务找对应领域,再看具体测试的输入和要求是否接近自己的使用场景。下表先给出概览,五个领域的完整介绍和分项图放在后面的“五个能力领域详解”,需要时可以从目录进入。
当前文本索引有五个能力领域。以 Jev 1.13.0 为例:
| 你想解决的问题 | 对应领域 | Jev 当前领域分 | 最新开源最高分(对应模型) | 可以尝试的场景 |
|---|---|---|---|---|
| 知道规则后,能否推出正确结果? | 知识与推理 | 46.2 | 49.68 · linne-oak 1.0(31B) | 知识判断、数学与代码推理、棋类决策 |
| 一段文本到底表达了什么? | 语言理解 | 58.3 | 64.73 · OneJev1.5-27B | 工单含义判断、评论情绪识别、文本与证据一致性判断 |
| 很多候选项里,哪个最相关? | 检索与分类 | 61.4 | 69.42 · linne-oak 1.0(31B) | 客服意图分类、候选文档重排、商品匹配 |
| 当前状态下,该选择哪个工具或动作? | 工具与自动化 | 73.71 | 82.76 · Darwin-27B-ZTC | 工具选择、调用判断、结构化动作 |
| 面对主观判断,能否贴近人的选择? | 艺术与人类偏好 | 46.15 | 59.19 · RSI-Jev v6.1 VL 27B(effort auto) | 内容偏好预测、幽默理解、素材筛选 |
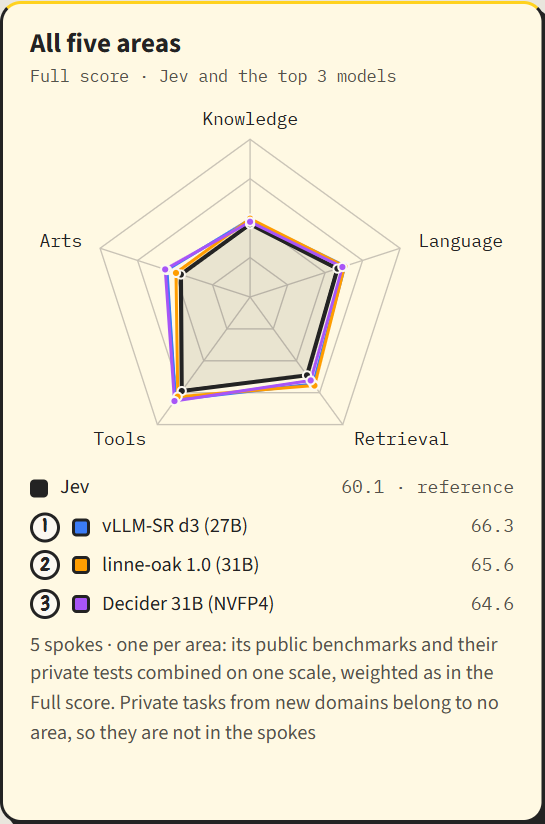
图 3:五领域概览。领域分数包含公开任务及其同能力私有测试;新领域私有任务没有归入这五条轴。
客服分流、资料排序:优先看检索与分类
如果你想把“退款进度”“账户登录”“商品咨询”等工单送到不同处理队列,可以关注 BANKING77、CLINC150 这样的意图分类任务。如果你想从检索结果中挑出最相关的资料,可以关注文档相关性测试,例如 BRIGHT。
如果需要判断工单情绪、立场,或者文本是否得到证据支持,还可以继续看语言理解领域的相关分项。同样是处理文本,分类、情绪判断和证据判断考查的能力不同。
由检索系统提供候选,再让 Jev 做分类或排序,是一个值得直接接入试用的方向。
工具选择:Jev 当前最突出的领域
工具与自动化的领域分为 73.71,是 Jev 在这五项里最突出的一个。最新开源最高分是 Darwin-27B-ZTC 的 82.76,比 Jev 高 9.05 个领域分。这是 Jev 自身的强项,但在这个领域,开源方案已经取得更高成绩,也值得一起比较。这里包括 BFCL、ToolRet、API-Bank、家电控制和 When2Call,关注工具选择、调用判断及结构化动作。
这与 Jev 的产品定位比较一致:把一个明确的状态,转成一次有限范围的选择。比如给定用户请求和可用工具,判断这一步应该查资料、调用接口,还是暂时不调用工具。
但“选对工具”只是自动化的一环。工具执行、权限检查、输入校验、重试和异常处理,都还需要程序承担。
扫雷:继续看具体的规则推理分项
我最关心的是知识与推理中的棋类决策:模型能不能读懂棋盘,把位置关系与规则结合起来,再选出正确行动?其中 ChessBench 正好帮助我理解这次扫雷为什么玩不好,后面会结合实验展开。
这五项放在一起,给出的启发很清楚:对当前 Jev 而言,工具选择、检索与文本判断,比复杂棋盘决策更值得优先试用。艺术与人类偏好也有素材筛选等用途,但目前还不是它的突出强项。
概率是否可信,响应是否够快?
得分高,同时自信是否匹配
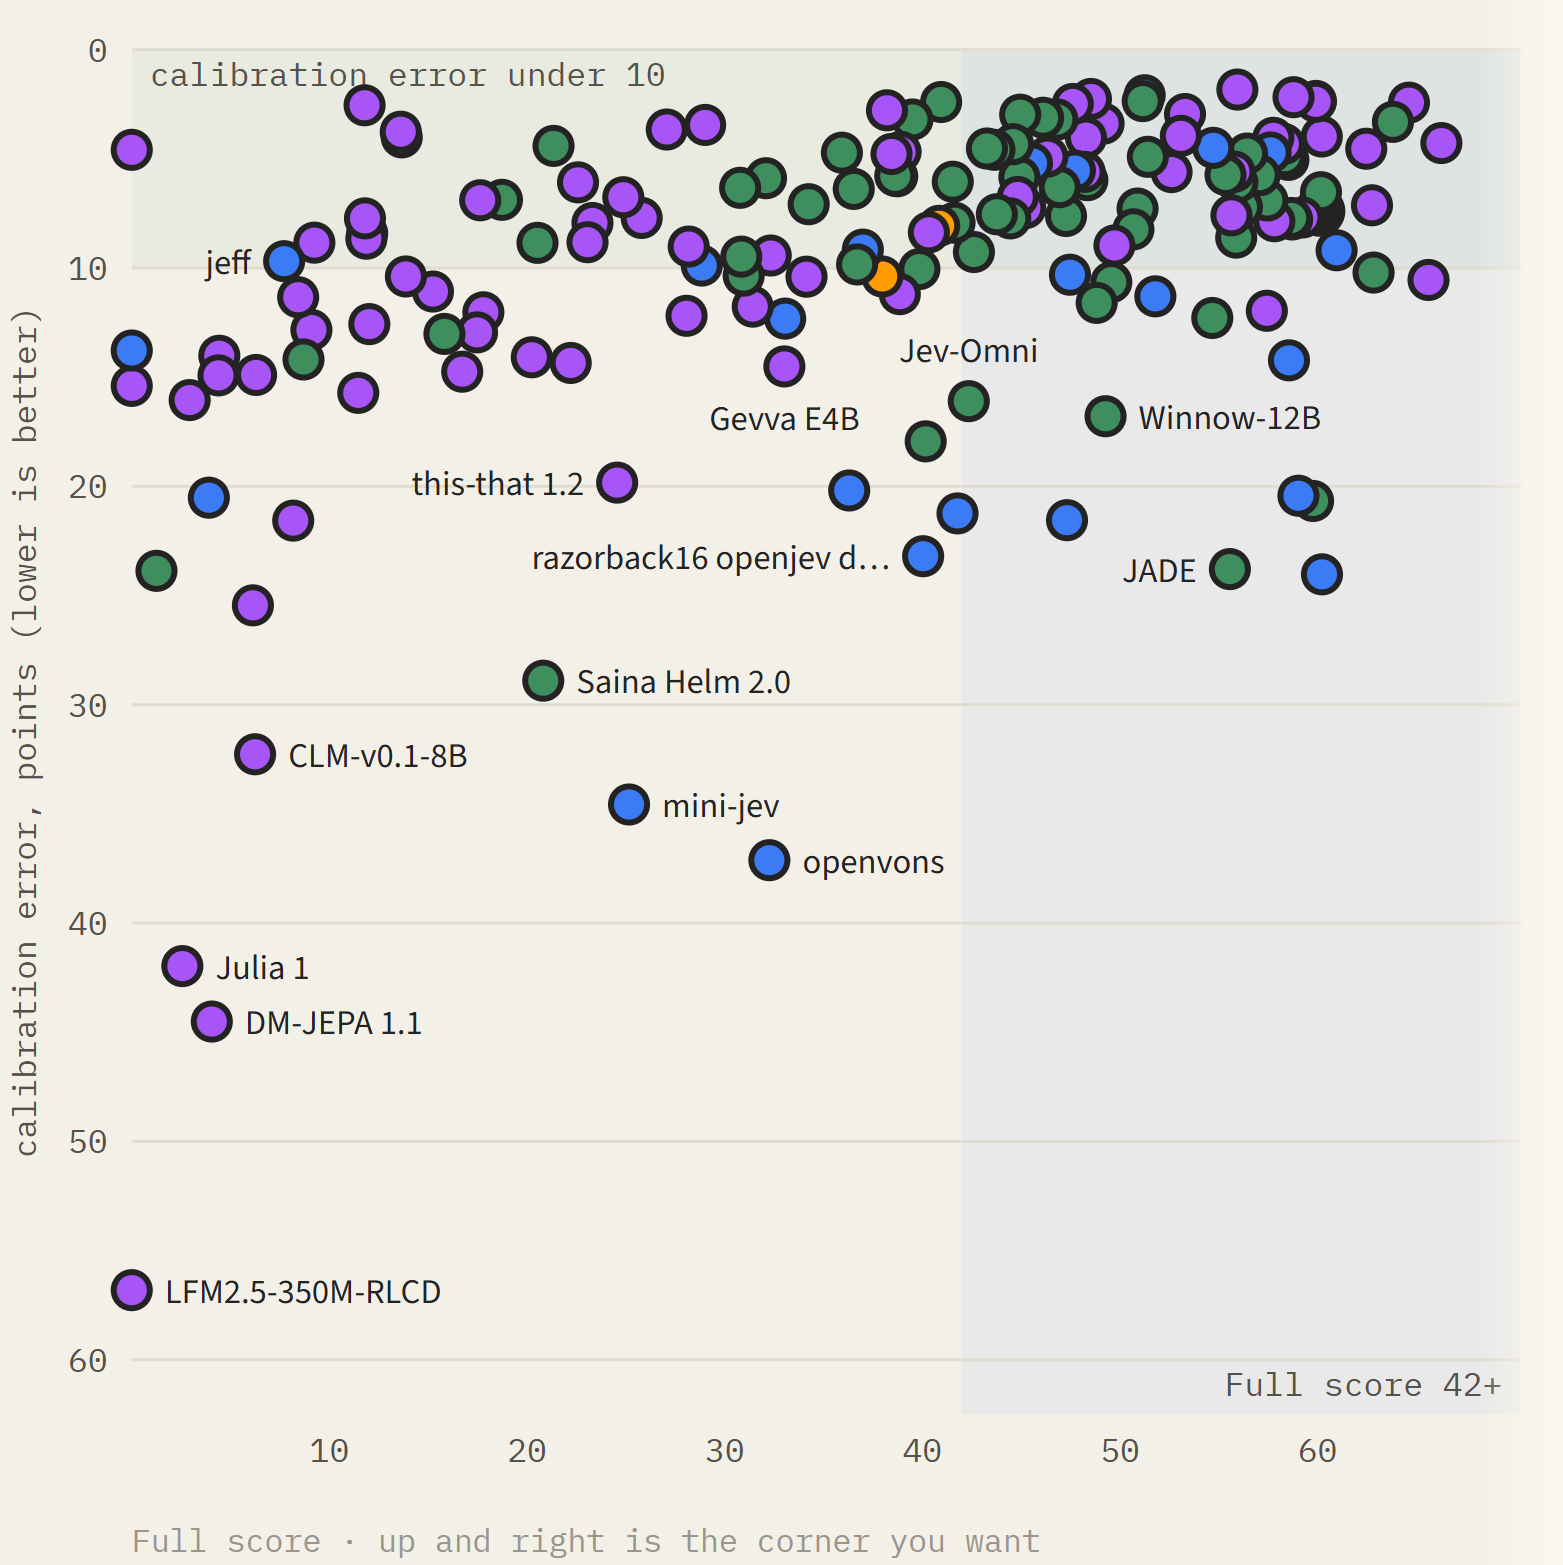
图 4:横轴是 Full score,纵轴是校准误差 ECE。纵轴倒置,越往上误差越小,因此右上方更理想。
“校准误差”不是一般的答错率。模型即使会答错,也可以比较诚实地表达不确定性;反过来,准确率不错的模型,也可能对答案过度自信或者不够自信。
网站用模型给最终选项的概率分桶,比较每个桶内的平均概率与实际正确率,再计算 ECE。这里用的是所选答案的概率,与 Jev API 的 confidence 字段并不是同一个量,后面的扫雷分析会具体说明这个差别。
当前数据中,Jev 的 ECE 为 7.40 个百分点,vLLM-SR d3 为 4.28,Decider 31B 为 2.43。这些开放方案不仅在综合分上领先,也在这份评测的校准指标上表现更好。
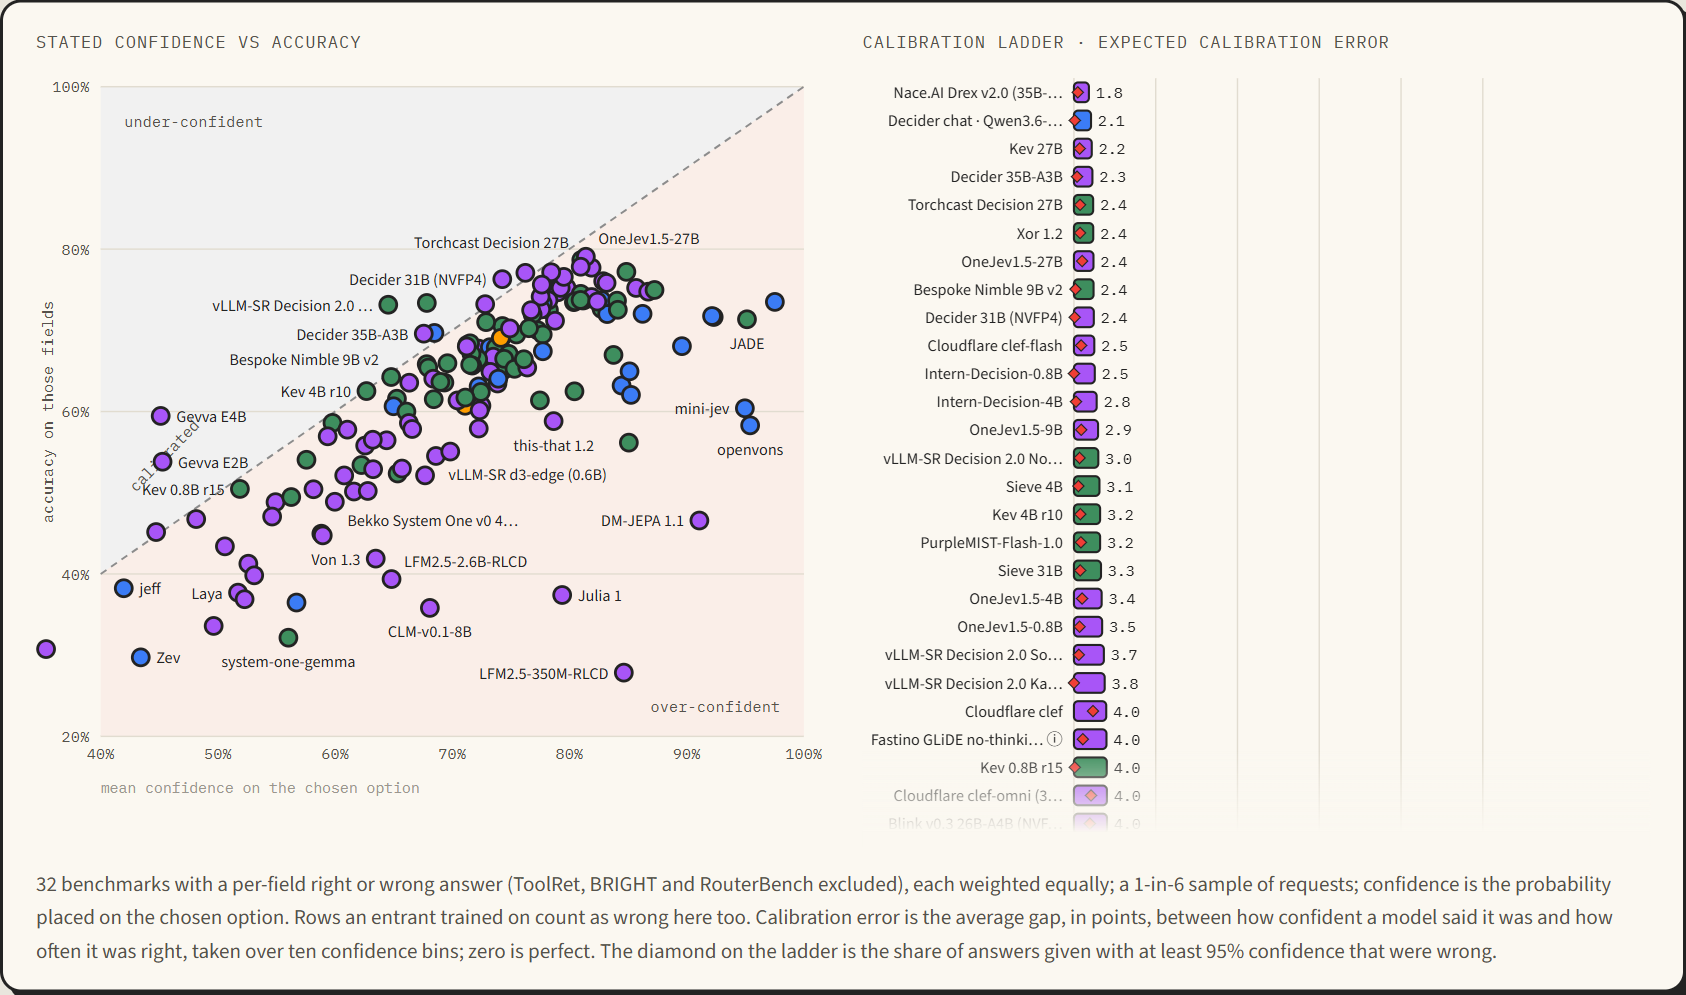
图 5:网站的校准详情。左图比较平均所选概率和实际准确率,右图比较 ECE;这些统计来自公开任务的校准样本,并非完整综合榜的私有测试表现。
对用户来说,这张图还有一个很实际的用途:能力接近时,优先选校准更好的模型。概率更可信,程序就更容易决定什么时候自动处理、什么时候回退。
得分与响应时间:速度很重要
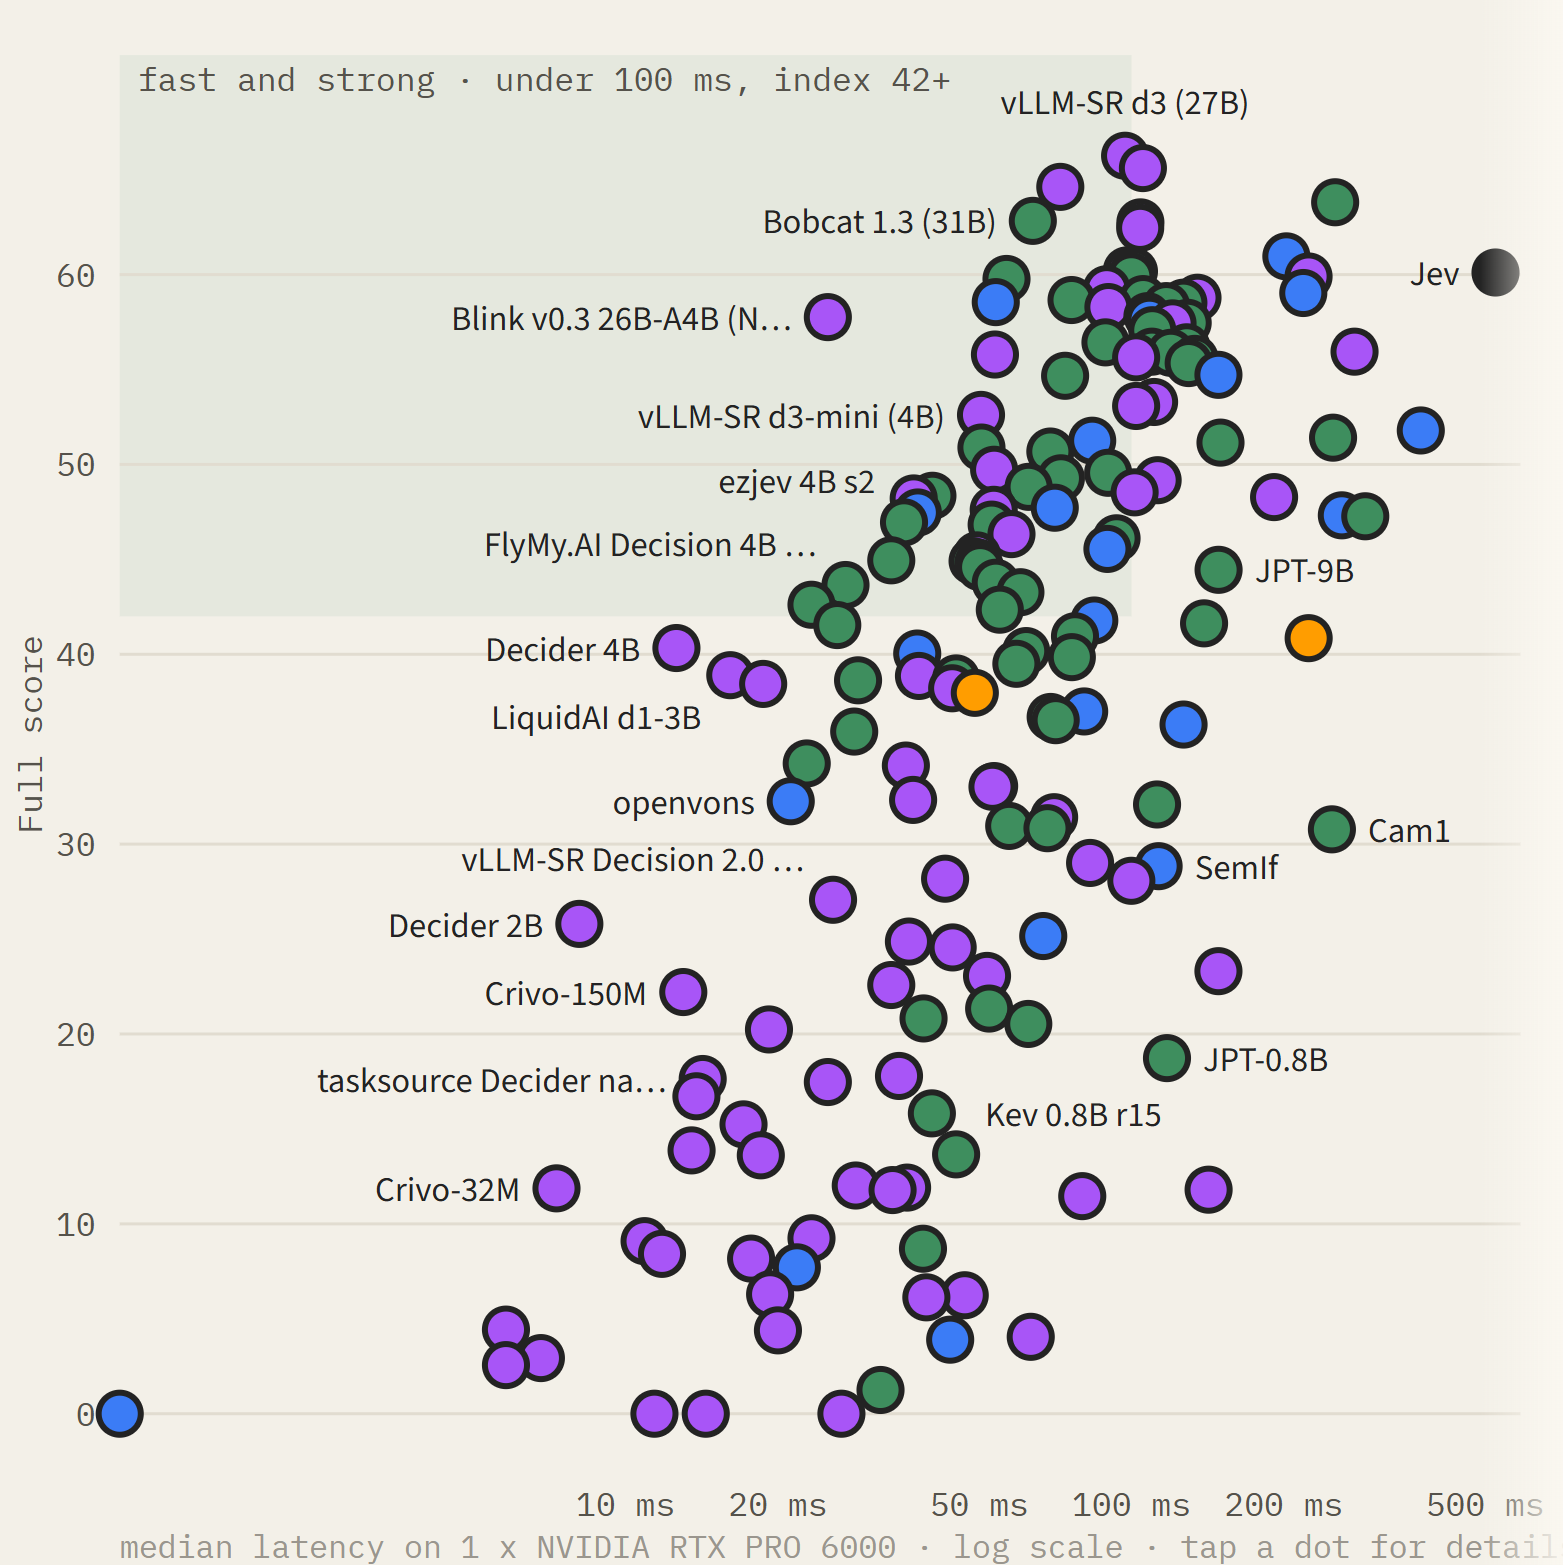
图 6:横轴为中位响应延迟,采用对数刻度;纵轴为 Full score。通常越靠左上,越接近“快且强”。
这张图很贴近业务:一次判断如果需要几秒,与几十毫秒就返回,能支持的交互和吞吐量完全不同。
但它有一个必须一起读的测量差异:开源复现运行在一张 NVIDIA RTX PRO 6000 上;Jev 是远程托管 API,延迟包含实验室到服务端的网络往返。当前标注的 Jev 中位延迟约 524 ms,vLLM-SR d3 约 97 ms,Decider 31B 约 72 ms,不能直接据此推导纯模型推理速度的倍数关系。
实际选型时,可以把这张图当作候选筛选,再在自己的部署环境里测端到端延迟、并发吞吐和成本。快、强、可信,应该一起评估。
实际读一次榜:我想做工单分流
假设我要做一个客服系统,让模型把工单分给“退款”“物流”“账户”和“其他”四个队列。我会这样使用 DI:
- 先找相关分项。 从检索与分类进入意图分类任务,阅读测试说明,确认它要求的是怎样的判断。需要理解情绪或证据时,再看语言理解的相关测试。
- 比较候选模型。 先比较相关分项表现,再结合综合分,选出值得尝试的几个方案。
- 看概率校准和部署条件。 如果系统要根据概率决定自动分流还是交给人工,就继续看 ECE;如果用户需要即时反馈,就看延迟,并区分托管 API 与本地部署。
- 拿自己的工单验证。 用一批已经知道正确去向的工单,检查错分、含糊请求和“其他”类别的处理效果,再调整选项、阈值和回退方式。
这样,DI 就能帮助我从一长串模型中找到值得接入的候选,再把验证精力花在自己的业务上。具体部署成本仍需要另行计算,榜单上的响应时间也要在自己的环境里复测。
扫雷也可以沿着这个顺序读榜:先看知识与推理,再看 ChessBench,最后回来检查自己的棋盘请求和实际执行结果。下面就是我这次进一步查看的过程。
回看扫雷:选对一步,概率分布仍值得检查
一次 Jev 返回结果
下面是另一条请求:初级难度,9×9 棋盘、10 颗雷,第 6 步,已经标记了 9 颗确认的雷。坐标从 0 开始,x 向右、y 向下;F 是确认的雷,# 是未揭开的格子,. 是已经揭开的零。
.......1#
.12321.1#
.2FFF1.1#
.2F43211F
.1111F111
....111..
.......11
111.1111F
1F1.1F###
请求明确要求:优先选可以证明安全的格子,否则选估计地雷概率最低的格子;多个格子同样安全时,可以任选。Jev 的回答是:
{
  "model": "jev-1.13.0",
  "choice": "8,2",
  "confidence": 0.06,
  "probabilities": {
    "8,2": 0.22,
    "6,8": 0.12,
    "8,1": 0.16,
    "7,8": 0.17,
    "8,8": 0.17,
    "8,0": 0.16
  }
}
第一眼看上去,模型只是在六个选项里勉强挑出了一个:最高概率 0.22,其他选项在 0.12~0.17 之间,几乎没有拉开差距。
再检查棋盘,会发现比低置信度更具体的问题。请求已经说明旗子是确认的雷,据此可以直接推导出:
| 候选格子 | 规则推导 | Jev 的选择概率 |
|---|---|---|
(8,2) | (7,2)=1 的唯一雷已由 (8,3) 的旗子占满,因此安全 | 0.22 |
(8,1) | 同样受 (7,2)=1 与 (8,3) 的约束,因此安全 | 0.16 |
(6,8) | (6,7)=1 已有确认雷 (5,8),因此安全 | 0.12 |
(7,8) | 同样受 (6,7)=1 与 (5,8) 的约束,因此安全 | 0.17 |
(8,8) | (7,7)=1 已有确认雷 (8,7),因此安全 | 0.17 |
(8,0) | (7,1)=1 周围其余未开格 (8,1)、(8,2) 已证明安全,因此这里是雷 | 0.16 |
这一步选中的 (8,2) 是安全格,但可以证明是雷的 (8,0),竟然也获得了 0.16 的选择概率,甚至高于另一个安全格。
它的分布没有清楚区分“可以点击”和“绝对不能点击”。这才是让我不放心的地方:这一步点对了,返回的判断却没有把雷排除。连续玩下去,出错就不奇怪了。
为什么五个安全格,也可能只有很低的置信度?
还要区分两种概率。这里的 probabilities 是一道 Choice 问题在候选答案上的分布,不能直接读成每个格子的地雷概率,也不能把 1 - probabilities[cell] 当作踩雷风险。
根据 TypeSafe 的置信度说明,Choice 的 confidence 是最高选择概率相对于均匀分布的归一化优势:
六个选项的均匀概率约为 0.167。代入返回的 0.22,得到约 0.064,与 0.06 一致。它反映的是“模型对某个选项的偏好有多明确”,不是该格子安全概率的直接估计。
这个局面有五个安全格,模型完全可以在它们之间任选。即使给五个安全格各分配 0.20、给雷格零概率,按公式算出的置信度也只有 0.04。判断这一步的质量,要看它有没有排除雷格。 Jev 的问题就在这里:它给一个已经能确定是雷的格子,仍然留了明显的选择概率。
这实验也说明:接口输出合法、答案带概率,不能代替任务本身的正确性。扫雷需要把多个局部约束合在一起,并且持续做对;偶尔选中安全格,还不足以支撑一整局自动执行。
ChessBench 的低分,让扫雷失败不再意外
ChessBench 给定国际象棋局面及所有合法走法,要求选出最强的一步;并列最佳走法也算正确。它是静态的走法选择测试,并不是让模型下完一整盘棋。可参见网站分项说明及其引用的 DeepMind 项目。
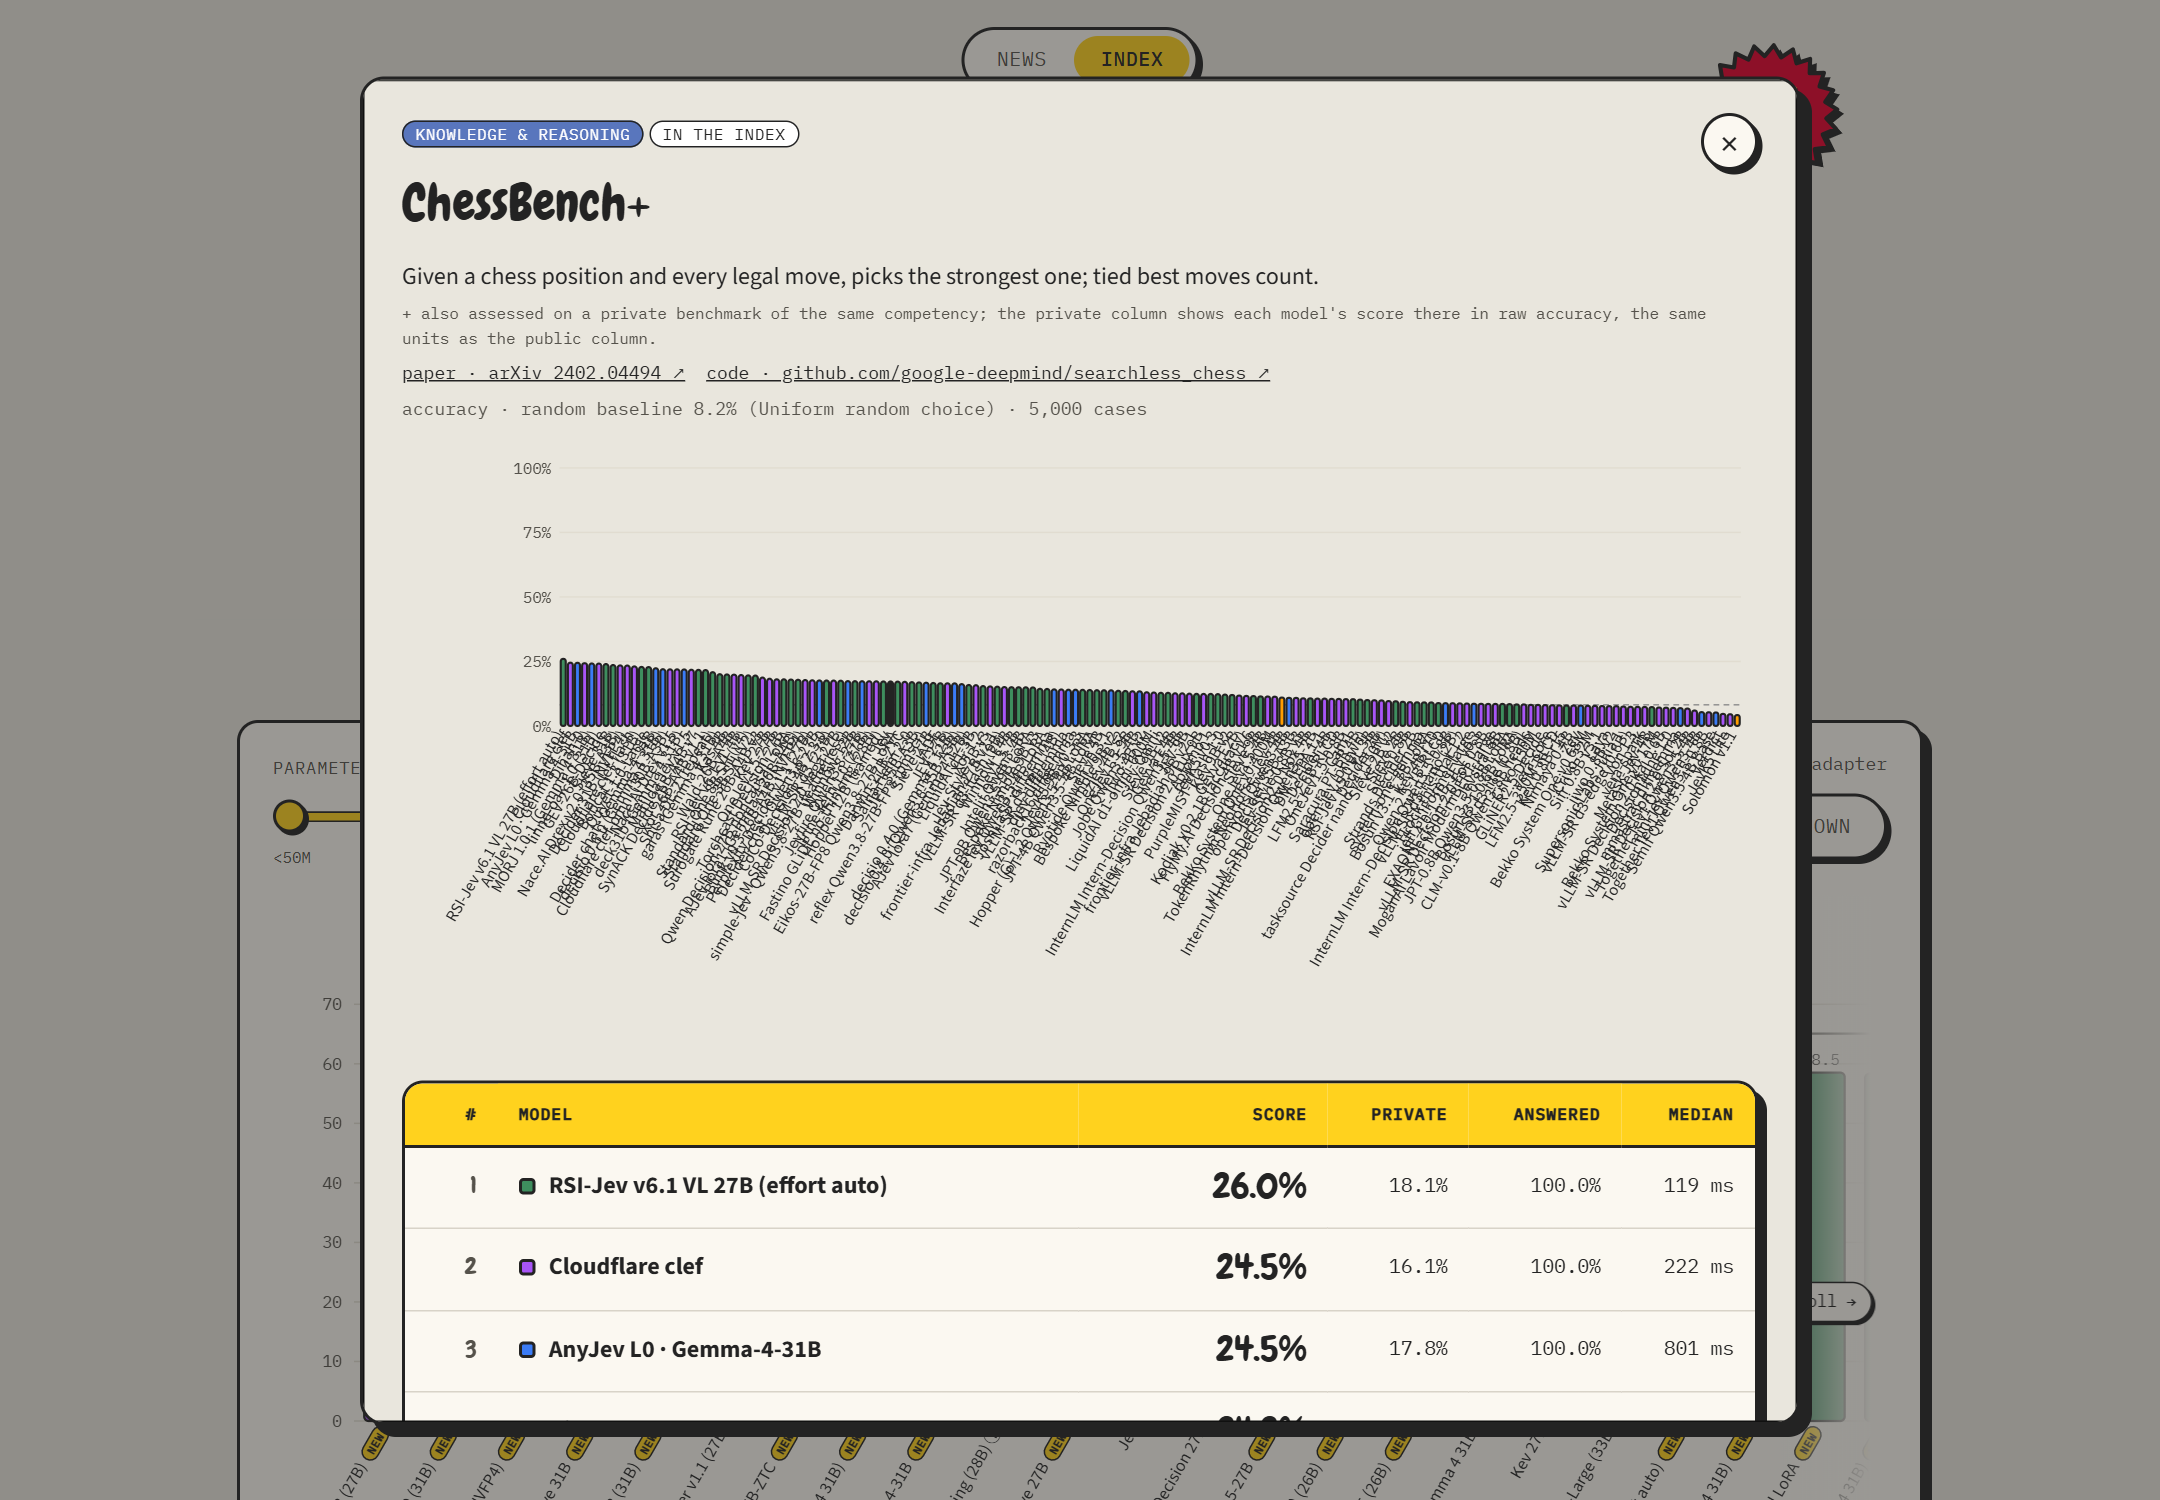
图 7:ChessBench 的任务说明和分项榜单。
榜单的数据中,Jev 的公开准确率为 17.22%,vLLM-SR d3 为 17.58%,最高的也仅为26.0%。
这些数字解释了为什么雷达图上的 ChessBench 一角明显收缩:即使综合分较高的开放模型,在这一项上也远没有达到稳定可靠的水平。
可以认为,ChessBench 的低分与扫雷失败有密切联系。 国际象棋和扫雷都要求模型读懂棋盘,把位置关系与规则结合起来,再选出正确的行动。这正是当前 Jev 的薄弱处。
国际象棋要判断走法优劣,扫雷要推出哪些格子安全,具体规则不同,但都离不开对棋盘状态的精确推理。Jev 在扫雷里连一个已经能推导出是雷的格子都没有从选择分布中排除,与 ChessBench 上的低分表现很一致。
看过这项成绩,我对扫雷失败就不意外了:模型在这方面的能力本来就弱,换一个棋盘游戏,并不会突然变强。 偶尔通关很好理解,连续稳定地做对每一步,才是真正的能力门槛。
而且,这个短板不只属于 Jev。目前综合榜领先的开放模型,ChessBench 分数同样低。想继续尝试扫雷,光换一个总分更高的模型,大概率也解决不了问题;要等相关分项能力真正上来。
我现在的选择是先停一下,等下一轮模型进展。看一下模型什么时候能真正进行扫雷,也是一个很有意思的等待。估计应该不用太久,因为现在的先进大模型的扫雷能力基本是够的,只是很慢。
Jev 到底该怎么用?强项接入,弱项先放一放
我的看法很简单:先看 Decision Index,找到与你的任务最接近的分项,再决定要不要接入。 这张榜的价值,就是帮助我们把时间花在模型已经擅长的地方。
- 如果是强项,可以基本放心地接入使用。 像工具选择、检索分类这样的方向,已经有不错的表现支撑,值得直接拿来做业务。当然,接入后还是要用自己的数据验证效果,调整选项、阈值和回退方式。这一步是把模型用好,没必要因为它偶尔会出错,就迟迟不开始。
- 如果是弱项,就先放一放。 ChessBench 这样的成绩已经很直观,相关任务大概率能力不行。与其不断改提示词、换输入格式、反复试错,不如等这个能力上来以后再正式接入。除非只是想体验一下它到底弱到什么程度,那像这次扫雷一样做个小实验也挺有意思。
看benchmark这事很重要。以前看到一个新模型,容易想把各种任务都交给它试一遍;其实应该先看能力分布。强项有现成的应用机会,弱项则适合继续观察更新。
验证当然需要,但验证的投入也应该跟着能力走:强项值得认真做接入、测业务效果;弱项没必要投入同样多的工程精力,试到明确不好用,就可以停下来。
对于 Jev,我会优先尝试工单分流、工具选择、候选资料排序这些任务。扫雷和类似的棋盘推理,先搁置。模型迭代这么快,等几轮更新,再回来看对应分项,往往比现在硬调更划算。
开源追赶之后,谁来定义这个领域?
TypeSafe AI 开创了一个 LLM 快速决策的新领域:把 AI 从输出文本,推进到输出软件可以直接消费的决策。现在,多个开放方案在同一张评测榜上追赶甚至超过 Jev,意味着这一方向正在变成一个生态。
从这轮追赶的速度看,开源迭代明显更快。TypeSafe 先打开了这个方向,现在却要面对多个团队同时推进:这个团队提高综合分,另一个改善校准,还有团队把模型做小、把推理做快。这样的竞争,对使用者是好事。
我的判断是,这个领域未来的主导权会在开源生态。 当结构化决策接口、模型实现和评测方法都可以被复现,先发者就很难独占整个方向。TypeSafe 可以继续把 Jev 和托管服务做好,但开发者会越来越习惯在不同模型之间比较和替换,领域的进展也会由更多团队共同推动。
接下来值得期待的,除了总分继续提高,还有更可信的概率、更强的领域专项模型,以及让不同模型按任务分工的工具链。对使用者而言,保持接口可替换、评测可复用,会比押注某一个榜首更有价值。
这次扫雷没有给我一个满意的游戏机器人,却让我更明确了怎样用好 Jev:看清强项就接入,看清弱项就等待。 不必要求一个新模型什么都能做,也不必在它已经暴露的短板上反复消耗时间。
如果你也在考虑使用这类模型,可以先打开 Decision Index,找到最接近自己任务的分项,挑出候选,再一起比较校准和速度。暂时没有接入计划,也可以从一个感兴趣的分项开始,观察模型更新后的变化。
接下来,我更关心的是怎么把 Jev 的强项真正用起来,同时盯着 Decision Index 的变化。等棋盘推理这块能力上来了,再回来扫雷。
五个能力领域详解(可跳过)
**阅读提示:**如果你只想了解 DI 怎么用,前面的任务对照表和工单分流示例已经可以帮助你开始读榜。下面保留五个领域的详细说明及最新分项图,供需要进一步了解测试内容的读者查阅;也可以通过目录折叠本节,直接跳到“想自己试试扫雷?”。
以下图表均采集自 2026 年 10 月 14 日的 DI 0.3.2 文本榜。每张图比较 Jev 与该领域排名前三的开放方案;图中领域分保留一位小数,正文列出两位小数,便于与前面的表格核对。
1. 知识与推理:知道规则,能否推出正确结果?
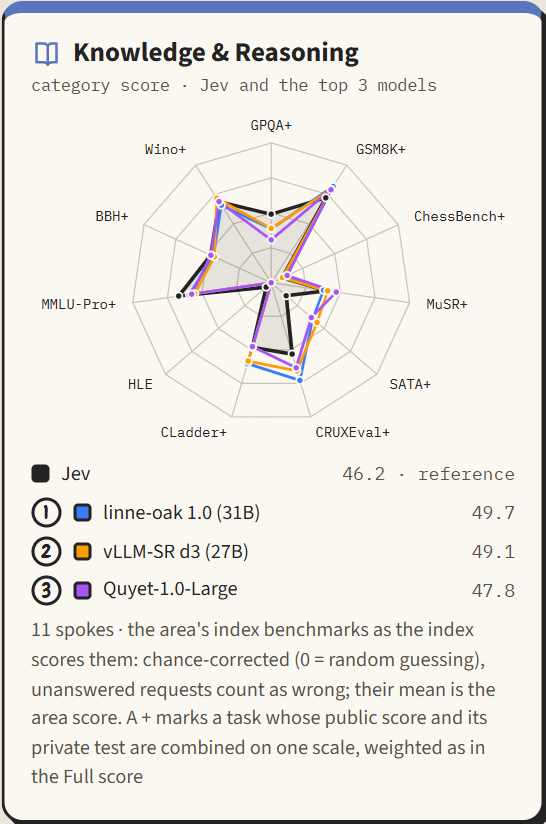
图 8:知识与推理领域。最新开源最高分为 linne-oak 1.0(31B)的 49.68。
它覆盖学术知识、常识、数学、代码与规则推理,包括 GPQA、GSM8K、MMLU-Pro、BBH、CRUXEval,以及本文尤其关注的 ChessBench。Jev 在这一领域的当前合成分为 46.17(概览表四舍五入为 46.2);最新开源最高分为 linne-oak 1.0(31B)的 49.68。
这个领域里,我最关心具体子项:知识问答、数学计算、代码推理、棋类决策,能力差异一眼就能看出来。尤其是 ChessBench,它正好帮助我理解这次扫雷为什么玩不好。
如果你想把模型用于规则判断或代码结果预测,可以先找相应子项,再看它与自己的问题是否接近。领域总分能显示整体表现,具体子项更能帮助我们找到要测试的能力。
2. 语言理解:一段文本到底表达了什么?
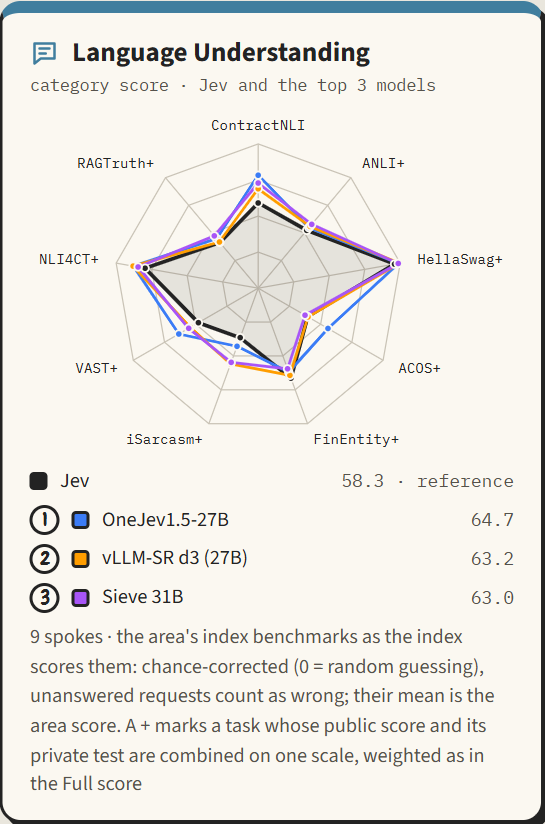
图 9:语言理解领域。最新开源最高分为 OneJev1.5-27B 的 64.73。
这一领域测试文本蕴含、情感、讽刺、立场等,代表任务包括 ContractNLI、ANLI、ACOS、iSarcasmEval、VAST,以及用于判断生成内容是否有幻觉的 RAGTruth。Jev 的当前领域分为 58.25(概览表四舍五入为 58.3);最新开源最高分为 OneJev1.5-27B 的 64.73。
它对应的业务比较直观:工单含义判断、评论情绪识别、文本与证据是否一致。模型做的是理解和判断,结果仍需要明确标签及后续处理规则。
例如,客服系统除了判断工单应该交给谁,还可能需要识别用户是否在表达不满;资料审核则可能需要判断一段结论是否得到提供的证据支持。可以按这些具体需求继续查看分项。
3. 检索与分类:很多候选项里,哪个最相关?
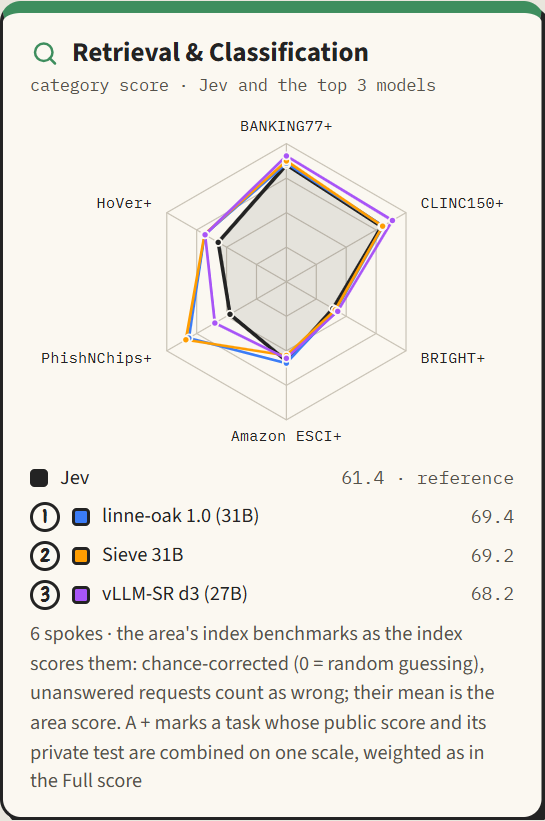
图 10:检索与分类领域。最新开源最高分为 linne-oak 1.0(31B)的 69.42。
它涵盖意图分类、文档相关性、商品匹配、钓鱼识别与证据判断,如 BANKING77、CLINC150、BRIGHT、Amazon ESCI、PhishNChips、HoVer。Jev 的当前领域分为 61.40;最新开源最高分为 linne-oak 1.0(31B)的 69.42。
这类任务很容易落到业务里:客服分流、候选文档重排、商品相关性判断。由检索系统提供候选,再让 Jev 做分类或排序,是一个值得直接接入试用的方向。
读榜时可以区分自己的问题是“分到哪个类别”,还是“候选资料中哪个最相关”,再找到对应测试。一个模型在意图分类上表现好,文档排序的表现仍值得单独查看。
4. 工具与自动化:这一步该调用什么?
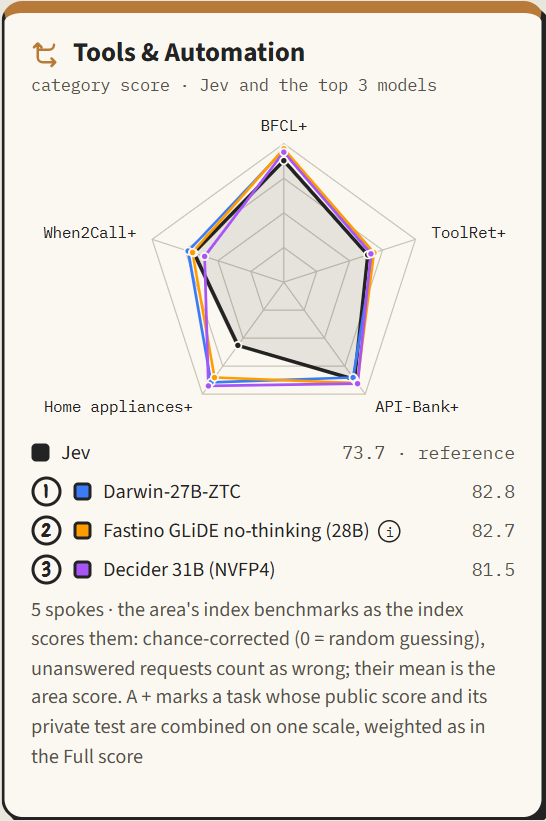
图 11:工具与自动化领域。最新开源最高分为 Darwin-27B-ZTC 的 82.76。
这一领域包括 BFCL、ToolRet、API-Bank、家电控制和 When2Call,关注工具选择、调用判断及结构化动作。Jev 的当前领域分为 73.71,是这五项里最突出的一个;最新开源最高分为 Darwin-27B-ZTC 的 82.76,比 Jev 高 9.05 个领域分。
这与 Jev 的产品定位比较一致:把一个明确的状态,转成一次有限范围的选择。给定当前状态和一组可用工具,模型可以判断下一步该选择什么,以及是否需要调用工具。
但“选对工具”只是自动化的一环。工具执行、权限检查、输入校验、重试和异常处理,都还需要程序承担。这是 Jev 自身的强项,选型时也值得把领域得分更高的开源方案放在一起比较。
5. 艺术与人类偏好:面对主观判断,能否贴近人的选择?
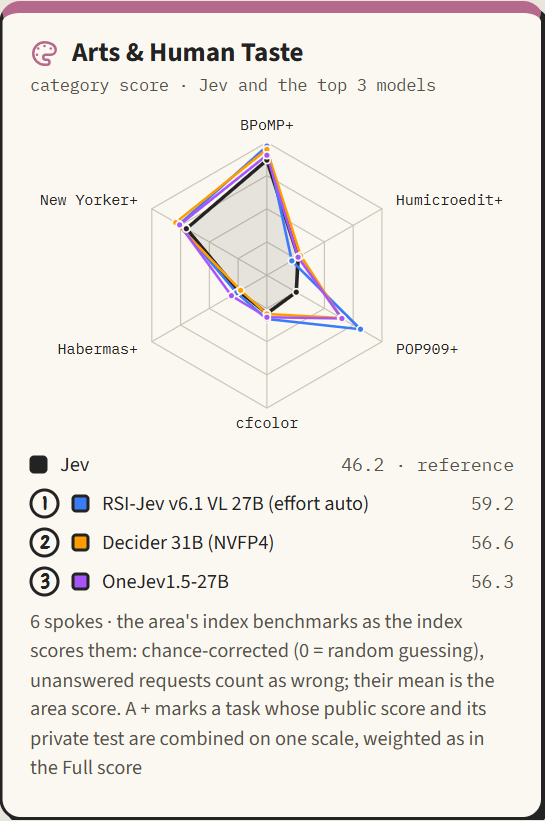
图 12:艺术与人类偏好领域。最新开源最高分为 RSI-Jev v6.1 VL 27B(effort auto)的 59.19。
这一领域涉及诗歌、音乐、幽默、颜色及人类偏好,包括 BPoMP、Humicroedit、POP909、cfcolor、Habermas 和 New Yorker。Jev 的当前领域分为 46.15;最新开源最高分为 RSI-Jev v6.1 VL 27B(effort auto)的 59.19。
这里测的是受约束的判断,业务上对应内容偏好预测、幽默理解或素材筛选。就当前分数看,这类任务还不是 Jev 的突出强项,应该把接入优先级放在工具选择和检索分类之后。
如果你想用它筛选标题、笑话或设计素材,可以先看测试具体比较的内容,再用自己的素材和目标受众偏好验证效果。
想自己试试扫雷?
这个扫雷测试的代码已经放在 GitHub 上。它支持 Jev 和 OpenAI 兼容接口,可以让不同模型来挑战扫雷;页面右侧会实时显示每一步的请求、选择和概率,观察起来很直观。
推荐对决策模型感兴趣的朋友也试一试。可以让 agent 帮你安装项目,然后在 config/providers.yaml 中填入对应模型的 API 配置。配置完成后,用下面这条命令让 Jev 挑战初级扫雷:
node scripts/play-all.mjs --provider jev --level beginner
换成 --provider openai,还能试试其他模型。具体安装和配置步骤可看仓库的中文说明。
本文依据个人试用记录、Decision Index 0.3.2、其方法说明和更新记录,以及 TypeSafe 的 Choice 文档和置信度文档撰写。DI 图表及网页截图重新采集于 2026 年 10 月 14 日 20 点(北京时间),对应网站 17 点后更新的数据。